Votre panier est vide.
L’agent de codage n’attend plus le développeur : le logiciel continue d’être développé même lorsque l’équipe est hors ligne
07 Oct
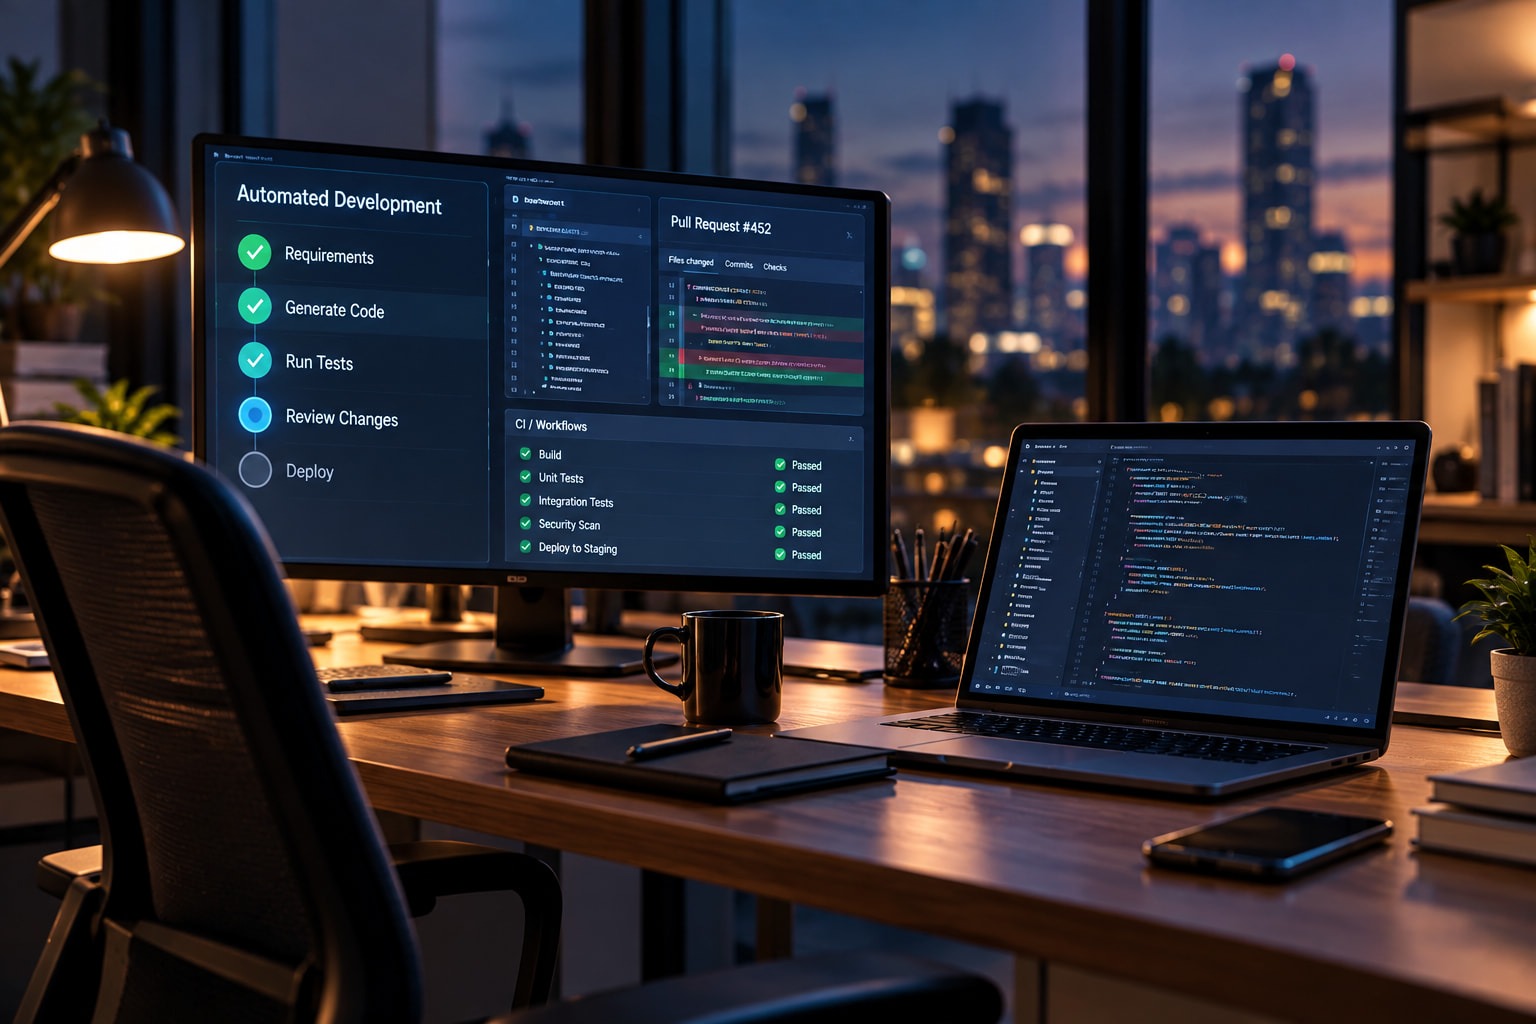
Depuis des décennies, le développement logiciel est directement lié à la présence du développeur.
Le développeur ouvre l’environnement de développement, analyse le problème, écrit le code, exécute les tests, examine les résultats, puis décide de l’étape suivante.
Même lorsque l’intelligence artificielle est entrée dans ce processus, le modèle initial est resté presque identique.
Le développeur était en ligne.
L’IA était là pour l’assister.
Mais les agents de codage commencent à transformer cette relation.
Avec l’exécution dans le cloud, la délégation des tâches et des processus capables de se poursuivre de manière indépendante, un agent n’a plus nécessairement besoin que le développeur reste devant son écran en permanence.
Une tâche peut être déléguée.
L’agent peut continuer à travailler dans le cloud.
Le développeur peut s’absenter.
Et lorsqu’il revient, une partie du travail peut déjà être terminée.
Cela peut sembler être une simple amélioration de la productivité.
Mais en réalité, cela pourrait marquer le début d’un changement beaucoup plus important dans l’architecture du développement logiciel.
De l’IA qui répond à l’IA qui continue à travailler
La plupart des premiers outils de programmation basés sur l’IA fonctionnaient de manière synchrone.
Le développeur posait une question.
L’IA répondait.
Le développeur examinait la réponse et décidait de ce qui devait se passer ensuite.
Même lorsque l’IA a commencé à utiliser des outils, des terminaux et des dépôts, le développeur restait généralement une partie active de la session.
Le nouveau modèle est différent.
Au lieu de diriger chaque étape, le développeur peut définir un objectif et déléguer son exécution à un agent.
L’agent peut analyser le dépôt, modifier des fichiers, exécuter des commandes, lancer des tests et poursuivre le processus dans un environnement cloud.
À ce stade, l’IA n’est plus simplement un outil qui attend une commande.
Elle devient un processus capable de continuer à travailler une fois la tâche déléguée.
Le cloud offre à l’agent de codage un environnement dans lequel travailler
L’un des changements les plus importants est le déplacement de l’exécution des agents vers le cloud.
Dans un modèle traditionnel, de nombreuses actions d’un agent de codage se déroulent sur l’appareil local du développeur.
Cela signifie que l’agent dépend de la session locale, de l’environnement du développeur et, dans de nombreux cas, de sa présence active.
L’exécution dans le cloud change cette situation.
La tâche peut être transférée vers un environnement distant dans lequel l’agent dispose du dépôt, des outils et des ressources dont il a besoin pour continuer à travailler.
Cela crée une nouvelle séparation.
Le développeur définit la tâche.
L’infrastructure crée l’environnement.
L’agent effectue le travail.
Le résultat est renvoyé à l’équipe pour être examiné.
Cela rend le processus de développement moins dépendant d’une seule session humaine.
Le développeur peut déléguer une tâche et passer à autre chose
Cela pourrait modifier la manière dont la journée d’un développeur est organisée.
Imaginons qu’un développeur identifie plusieurs tâches le matin.
Un agent prend en charge la mise à jour d’un module.
Un autre analyse un problème dans les tests.
Un autre processus examine une pull request.
Pendant ce temps, le développeur peut se concentrer sur l’architecture, un problème plus complexe ou une réunion d’équipe.
Lorsqu’il revient aux tâches déléguées, il ne doit pas nécessairement repartir de zéro.
Les agents peuvent avoir produit des implémentations, des résultats de tests ou des propositions déjà prêtes à être examinées.
Cela modifie la relation entre le temps humain et le temps d’exécution du logiciel.
Dans le modèle traditionnel, le travail s’arrête souvent lorsque le développeur s’arrête.
Dans le modèle basé sur les agents, le processus peut continuer.
Le logiciel peut être développé même en dehors des heures d’activité de l’équipe
C’est ici qu’apparaît une possibilité encore plus intéressante.
Si un agent peut travailler dans le cloud sans qu’un développeur le surveille constamment, certains processus ne doivent plus nécessairement être limités aux heures pendant lesquelles l’équipe est active.
Une tâche peut être préparée et déléguée.
Un processus peut être exécuté plus tard.
Une vérification peut être effectuée périodiquement.
Un agent peut analyser les résultats et préparer le travail pour l’étape suivante.
Le matin, l’équipe peut ne plus trouver uniquement une liste de tâches à commencer.
Elle peut trouver des résultats à vérifier.
Cela ne signifie pas que le logiciel doit se modifier lui-même sans supervision.
Cela signifie que certaines parties du processus de développement peuvent continuer sans nécessiter la présence constante d’une personne.
Des sessions aux tâches
Ce changement peut sembler mineur, mais sur le plan architectural, il est extrêmement important.
Jusqu’à présent, l’interaction avec de nombreux outils d’IA était organisée autour de sessions.
Le développeur ouvre une session.
Il fournit des instructions.
L’IA répond.
La session se termine.
Mais les agents autonomes déplacent ce modèle vers un concept différent :
la tâche.
Une tâche possède un objectif.
Elle dispose d’un environnement d’exécution.
Elle dispose d’outils et de contraintes.
Elle possède un état.
Et elle produit un résultat qui doit être renvoyé au développeur.
Cela rapproche le développement piloté par l’IA d’autres systèmes distribués dans lesquels les processus peuvent s’exécuter indépendamment et les résultats être récupérés ultérieurement.
Les tâches planifiées pourraient créer une nouvelle catégorie d’automatisation
Lorsque les agents de codage sont combinés à l’exécution dans le cloud et à la planification des tâches, les possibilités s’élargissent encore davantage.
Toutes les tâches ne doivent pas nécessairement commencer par une commande directe du développeur à cet instant précis.
Certaines tâches peuvent être répétées.
Par exemple, un agent peut inspecter périodiquement une partie d’un projet.
Il peut analyser de nouveaux problèmes.
Il peut préparer des mises à jour.
Il peut exécuter des contrôles définis par l’équipe.
Il peut identifier les situations qui nécessitent une intervention humaine.
Cela fait évoluer l’IA d’un outil activé uniquement lorsque le développeur le demande vers un composant continu du processus de développement.
L’autonomie ne signifie pas nécessairement l’indépendance
Une distinction importante doit être faite ici.
Le fait qu’un agent de codage puisse continuer à travailler sans la présence du développeur ne signifie pas nécessairement qu’il doit prendre toutes les décisions de manière autonome.
L’autonomie peut avoir différents niveaux.
Un agent peut être autorisé à analyser le dépôt.
Il peut être autorisé à modifier une branche isolée.
Il peut exécuter des tests.
Il peut préparer une pull request.
Mais il peut ne pas être autorisé à fusionner cette modification avec la branche principale.
De cette manière, le processus peut être autonome dans son exécution tout en restant contrôlé dans la prise de décision.
Cette distinction sera essentielle pour l’architecture des systèmes construits autour des agents de codage.
Plus l’agent travaille longtemps seul, plus la traçabilité devient importante
Lorsqu’un développeur suit chaque étape d’un agent en temps réel, il est relativement facile de comprendre ce qui se passe.
Mais que se passe-t-il lorsque l’agent travaille pendant une période prolongée sans supervision directe ?
Le système doit alors être capable d’expliquer le processus.
Quels fichiers l’agent a-t-il analysés ?
Qu’a-t-il modifié ?
Quelles commandes a-t-il exécutées ?
Quels tests ont réussi ?
Quels tests ont échoué ?
Quelles décisions a-t-il prises ?
À quel moment a-t-il demandé, ou aurait-il dû demander, une intervention humaine ?
Plus le développement passe des sessions interactives aux tâches autonomes, plus cette traçabilité devient importante.
Le développeur ne doit pas voir uniquement le résultat.
Il doit également pouvoir comprendre le chemin suivi par l’agent pour y parvenir.
Le développement autonome exige des limites claires
L’exécution dans le cloud apporte de la flexibilité, mais elle soulève en même temps une question importante en matière de sécurité :
Qu’est-ce que l’agent est autorisé à faire lorsque personne ne le surveille directement ?
C’est ici que se rejoignent plusieurs des défis architecturaux les plus importants liés aux agents.
Peut-il modifier tous les fichiers ?
Peut-il installer des packages ?
Peut-il se connecter à Internet ?
Peut-il utiliser des identifiants d’accès ?
Peut-il créer des pull requests ?
Peut-il exécuter des workflows ?
Peut-il décider lui-même quand une tâche est terminée ?
L’autonomie sans limites peut créer des risques.
Par conséquent, le développement autonome ne doit pas être construit uniquement autour des capacités du modèle.
Il doit être construit autour des limites du système qui contrôle le modèle.
Le développeur passe du rôle d’opérateur à celui de superviseur
Dans un modèle traditionnel, le développeur est le principal opérateur du processus.
Il écrit les commandes.
Il modifie les fichiers.
Il exécute les tests.
Il passe d’une étape à la suivante.
Avec les agents de codage, une partie de cette exécution peut être déléguée.
Cela ne retire pas le développeur du processus.
Mais cela modifie l’endroit où sa valeur est créée.
Au lieu d’exécuter manuellement chaque étape, le développeur doit définir :
Quel objectif l’agent doit-il atteindre ?
Quelles ressources peut-il utiliser ?
Que ne doit-il pas modifier ?
Quels tests doivent réussir ?
Dans quelles situations doit-il s’arrêter ?
Quels résultats nécessitent une approbation humaine ?
Ces questions relèvent de plus en plus de l’orchestration et de l’architecture plutôt que de l’exécution manuelle.
Un nouveau modèle de travail pourrait émerger : le développeur délègue, l’IA exécute, le développeur vérifie
Si cette évolution se poursuit, le cycle de développement pourrait être de plus en plus organisé autour de trois étapes.
Délégation.
Le développeur définit le problème, les limites et les critères de réussite.
Exécution.
L’agent travaille de manière indépendante dans un environnement contrôlé, qu’il soit local ou dans le cloud.
Vérification.
Le développeur ou le système de revue vérifie le résultat avant que la modification ne soit intégrée au logiciel.
Ce modèle est très différent de la programmation traditionnelle.
Le développeur n’est plus nécessairement la personne qui effectue chaque action.
Il devient la personne qui conçoit, contrôle et vérifie la manière dont le travail est effectué.
Le développement logiciel autonome devient un problème architectural
Pour ALSoft, le développement logiciel autonome ne doit pas être considéré simplement comme un moyen de produire davantage de code en moins de temps.
Il modifie l’architecture même du processus de développement.
À partir du moment où un agent de codage peut poursuivre une tâche dans le cloud même après que le développeur a quitté la session, l’équipe doit définir non seulement ce que l’IA peut faire, mais également comment contrôler le travail qu’elle effectue sans supervision continue.
Cela comprend l’isolation de l’environnement, les limites d’accès, la traçabilité, les critères d’achèvement, les tests automatisés et les points auxquels une approbation humaine est requise.
Comme l’explique Ermal Beqiri, fondateur d’ALSoft :
« L’étape majeure n’est pas simplement que l’IA puisse écrire du code. Le véritable changement commence lorsqu’un développeur peut déléguer un objectif, quitter la session et revenir pour trouver un résultat produit entre-temps. À ce moment-là, nous n’automatisons pas simplement le codage ; nous concevons un nouveau système de travail dans lequel l’autonomie de l’IA doit s’accompagner de limites, de traçabilité et d’un contrôle humain. »
Les agents de codage transforment progressivement la relation entre les personnes et le processus de développement.
Au début, l’IA attendait le développeur.
Puis elle a commencé à suggérer du code.
Ensuite, elle a commencé à utiliser des outils et à exécuter des commandes.
Aujourd’hui, l’étape suivante commence à apparaître :
une IA qui continue à travailler même lorsque le développeur n’est plus dans la session.
Cela pourrait créer des équipes de développement logiciel travaillant de manière beaucoup plus asynchrone.
Les humains définissent les objectifs et prennent les décisions critiques.
Les agents prennent en charge une part de plus en plus importante de l’exécution.
Et l’infrastructure relie ces deux mondes en définissant ce qui peut être effectué automatiquement et ce qui doit attendre l’intervention d’un humain.
Dans ce modèle, la question n’est plus simplement :
« Quelle quantité de code l’IA peut-elle écrire ? »
La question la plus intéressante devient :
« Combien de temps le processus de développement peut-il continuer sans que le développeur soit devant son écran ? »