Nessun prodotto nel carrello.
Da una vulnerabilità alla correzione successiva: come sta creando l’IA una memoria della sicurezza?
28 Sep
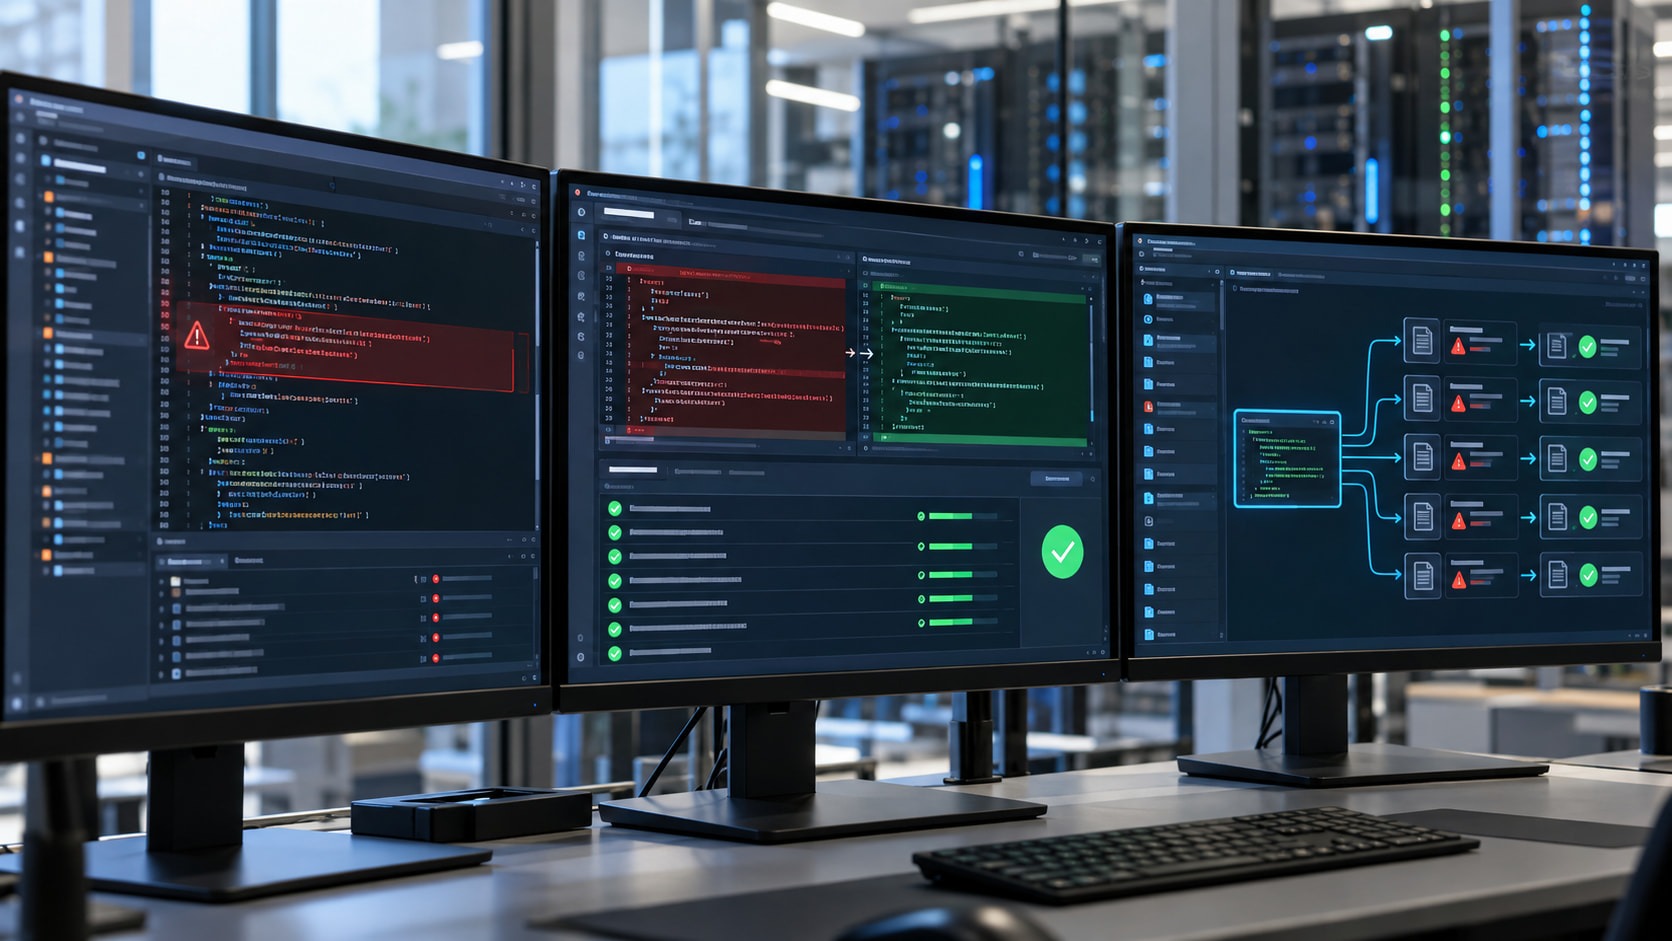
La correzione di una vulnerabilità del software viene generalmente considerata come la risoluzione di un problema specifico. Il team identifica la causa, prepara la modifica, verifica il codice e chiude la segnalazione di sicurezza. Le conoscenze create durante questo processo possono essere documentate, ma non sempre vengono recuperate automaticamente quando si presenta un problema simile.
L’utilizzo dell’Intelligenza Artificiale sta cambiando questo modello. I sistemi di correzione automatizzata possono analizzare le vulnerabilità, proporre modifiche e aiutare gli sviluppatori a preparare le soluzioni. Ora sta emergendo anche un’altra capacità: conservare il modello della correzione affinché possa essere riutilizzato in futuro.
Questo crea ciò che può essere descritto come una memoria della sicurezza dell’IA. Il sistema non si limita a correggere il problema attuale, ma conserva il contesto utile della soluzione e lo utilizza per gestire altre segnalazioni all’interno dello stesso repository.
Il 25 settembre 2026, GitHub ha annunciato che Agentic Autofix può utilizzare Copilot Memory per i clienti che hanno attivato questa funzionalità. Quando il sistema crea una correzione, memorizza il modello della soluzione per utilizzarlo in futuro. Secondo GitHub, queste memorie possono inoltre aiutare altre funzionalità di Copilot, come la revisione del codice e l’agente cloud, a comprendere i modelli di sviluppo sicuro specifici del repository interessato. Agentic Autofix e Copilot Memory sono attualmente disponibili in anteprima pubblica.
La correzione di una vulnerabilità crea nuove conoscenze
Ogni vulnerabilità individuata rivela qualcosa sul modo in cui è stato costruito un sistema.
Il problema può essere legato a una validazione insufficiente dei dati, a una gestione errata delle autorizzazioni, all’utilizzo di una funzione non sicura o al modo in cui i componenti si scambiano le informazioni. La correzione non modifica soltanto alcune righe di codice. Rivela anche un modello tecnico che dovrebbe essere evitato in futuro.
Nei processi tradizionali, queste conoscenze possono rimanere in possesso dello sviluppatore che ha effettuato la correzione, nella discussione di una pull request o nella documentazione interna. Quando si presenta un altro problema simile, il team deve trovare e interpretare nuovamente queste informazioni.
Copilot Memory consente di conservare il modello della correzione in una forma che il sistema di IA può recuperare durante l’analisi di un’altra segnalazione. Invece di trattare ogni problema come un caso completamente nuovo, l’IA può utilizzare le conoscenze generate dalle correzioni precedenti.
La memoria è collegata al contesto del repository
Non tutte le pratiche di sicurezza vengono applicate allo stesso modo in ogni progetto.
Due applicazioni possono utilizzare lo stesso linguaggio di programmazione, ma avere architetture, librerie e standard differenti. Un metodo di correzione adatto a un repository potrebbe non essere la soluzione giusta per un altro.
Per questo motivo, il valore di Copilot Memory non consiste soltanto nella conservazione di una regola generale di sicurezza. È legato alla capacità di apprendere dal modo in cui i problemi sono stati risolti all’interno di uno specifico repository.
Se un team utilizza un meccanismo specifico per le autorizzazioni, la validazione o la gestione degli errori, le correzioni precedenti possono fornire all’IA il contesto necessario per comprendere come affrontare problemi simili in quel progetto.
Questo avvicina il sistema agli standard effettivamente adottati dal team e riduce la possibilità che proponga una soluzione generica non adatta all’architettura esistente.
Da una correzione ad altre segnalazioni
Uno stesso modello di vulnerabilità può comparire in diverse parti della medesima base di codice.
Se una vulnerabilità è stata causata dall’utilizzo errato di una funzione, lo stesso utilizzo potrebbe essere presente anche in altri file. Se il problema è legato alla mancanza di un controllo delle autorizzazioni, la stessa lacuna potrebbe essersi ripetuta in processi simili.
Quando il modello della correzione viene conservato, il sistema può utilizzarlo come contesto durante la gestione di altre segnalazioni. Ciò non significa che la stessa modifica debba essere copiata automaticamente ovunque. Significa che l’IA dispone di un punto di partenza migliore per comprendere come il team abbia risolto in precedenza quella categoria di problema.
La memoria della sicurezza dell’IA può quindi trasformare una singola correzione in conoscenze riutilizzabili per l’intero repository.
Un agente può trasmettere le proprie conoscenze a un altro agente
Uno dei cambiamenti più importanti consiste nel fatto che la memoria non rimane limitata al sistema che ha creato la correzione.
Secondo GitHub, i modelli memorizzati possono essere utilizzati anche da altre funzionalità di Copilot. Una soluzione creata durante una correzione automatizzata può fornire contesto a un agente che esamina il codice oppure a un agente cloud che sta implementando un’altra modifica.
Questo crea una nuova forma di collaborazione tra i sistemi di IA. Un agente individua il modo corretto per correggere un problema, mentre altri agenti possono utilizzare tali conoscenze durante le proprie attività.
In un processo di questo tipo, la memoria diventa un livello di contesto condiviso. Aiuta gli agenti a non funzionare come strumenti isolati, ma a operare secondo le stesse pratiche e decisioni tecniche.
La revisione del codice può utilizzare lo storico delle correzioni
La revisione del codice si concentra generalmente sulla modifica proposta in quel momento. Lo sviluppatore o il sistema automatizzato analizza se il codice è corretto, sicuro e conforme agli standard del progetto.
Quando esiste una memoria delle correzioni precedenti, la revisione del codice può disporre di un contesto più ampio.
Se una nuova modifica reintroduce un modello che in precedenza ha causato una vulnerabilità, il sistema può individuarlo più facilmente. Se il team ha approvato un determinato modo di risolvere un problema di sicurezza, l’IA può utilizzarlo come riferimento durante la revisione del nuovo codice.
Questo sposta la sicurezza dalla reazione successiva alla scoperta di una vulnerabilità alla sua prevenzione durante il processo di sviluppo.
La memoria non serve soltanto a correggere i problemi più rapidamente. Può anche aiutare a impedire che lo stesso errore si ripresenti.
Le conoscenze memorizzate devono essere controllabili
La memoria di un sistema di IA non deve essere considerata automaticamente una fonte infallibile.
Una correzione precedente potrebbe essere stata adeguata al contesto di quel momento, ma non a un’architettura che nel frattempo è cambiata. Un modello può diventare obsoleto dopo l’aggiornamento di una libreria o una modifica degli standard di sicurezza.
Esiste inoltre la possibilità che una soluzione memorizzata fosse incompleta o eccessivamente legata a un caso specifico. Se viene utilizzata senza verifica, potrebbe portare a decisioni inadeguate in altre situazioni.
Per questo motivo, la memoria deve essere gestita come qualsiasi altra risorsa tecnica. Deve essere possibile comprendere da dove proviene un modello, quando è stato creato, in quale contesto è stato utilizzato e se continua a essere valido.
La memoria non sostituisce la verifica umana
Una proposta basata su una correzione precedente può essere più adatta al repository, ma deve comunque essere controllata.
Gli sviluppatori devono verificare se la modifica elimina realmente la vulnerabilità, se crea effetti collaterali e se rispetta l’architettura attuale. I test automatizzati possono confermare una parte del comportamento, ma non necessariamente tutte le conseguenze di una decisione relativa alla sicurezza.
Il ruolo dell’IA consiste nel fornire contesto, identificare modelli e preparare una soluzione più informata. La responsabilità di accettare la modifica rimane al team che gestisce il sistema.
Quanto più l’IA apprende dalla storia del repository, tanto più diventa importante che questa storia sia accurata e verificata.
La sicurezza può diventare una conoscenza condivisa del sistema
In molte organizzazioni, le pratiche di sicurezza sono distribuite tra la documentazione, le regole di analisi statica, le revisioni del codice e l’esperienza degli specialisti. La sfida consiste nel trasformare queste conoscenze in una parte attiva del processo di sviluppo.
La memoria della sicurezza dell’IA può contribuire a riunire questi elementi. Quando il sistema conserva il modo in cui un problema è stato corretto e fornisce questo contesto ad altri strumenti, le pratiche di sicurezza diventano più accessibili durante il lavoro quotidiano.
Un agente che scrive codice, un sistema che esamina una pull request e uno strumento che gestisce le segnalazioni possono basarsi sugli stessi modelli approvati.
Ciò può creare una maggiore continuità tra il rilevamento, la correzione e la prevenzione delle vulnerabilità.
La memoria della sicurezza richiede una governance chiara
Per ALSoft, la capacità dell’IA di conservare e riutilizzare le correzioni di sicurezza rappresenta un passo importante verso sistemi che apprendono dalla propria storia tecnica. Tuttavia, questa capacità deve essere accompagnata da regole chiare per la creazione, l’utilizzo e l’aggiornamento della memoria.
Le organizzazioni devono stabilire quali correzioni possono essere conservate, chi le verifica, quali agenti possono utilizzarle e quando un modello obsoleto deve essere riesaminato o eliminato.
Come spiega Ermal Beqiri, fondatore di ALSoft:
«Quando un sistema di IA conserva il modo in cui una vulnerabilità è stata corretta, non sta semplicemente memorizzando alcune righe di codice. Sta costruendo conoscenze sul modo in cui l’organizzazione affronta la sicurezza. Questa memoria può migliorare le correzioni future, ma deve essere verificata, controllabile e sempre collegata al contesto in cui è stata creata.»
La correzione automatizzata sta passando dalla risoluzione di una singola segnalazione alla creazione di conoscenze che possono essere riutilizzate. Ogni vulnerabilità risolta può diventare una fonte di contesto per i problemi che si presenteranno successivamente.
Ciò non significa che l’IA conoscerà automaticamente la soluzione corretta per ogni vulnerabilità. Significa, tuttavia, che il sistema non deve iniziare ogni analisi da zero.
Quando le correzioni precedenti vengono conservate, verificate e utilizzate con attenzione, la memoria della sicurezza dell’IA può trasformare la storia tecnica di un repository in un meccanismo attivo di protezione.