Nessun prodotto nel carrello.
Il codice non basta: perché i repository devono comprendere anche il contesto aziendale?
30 Sep
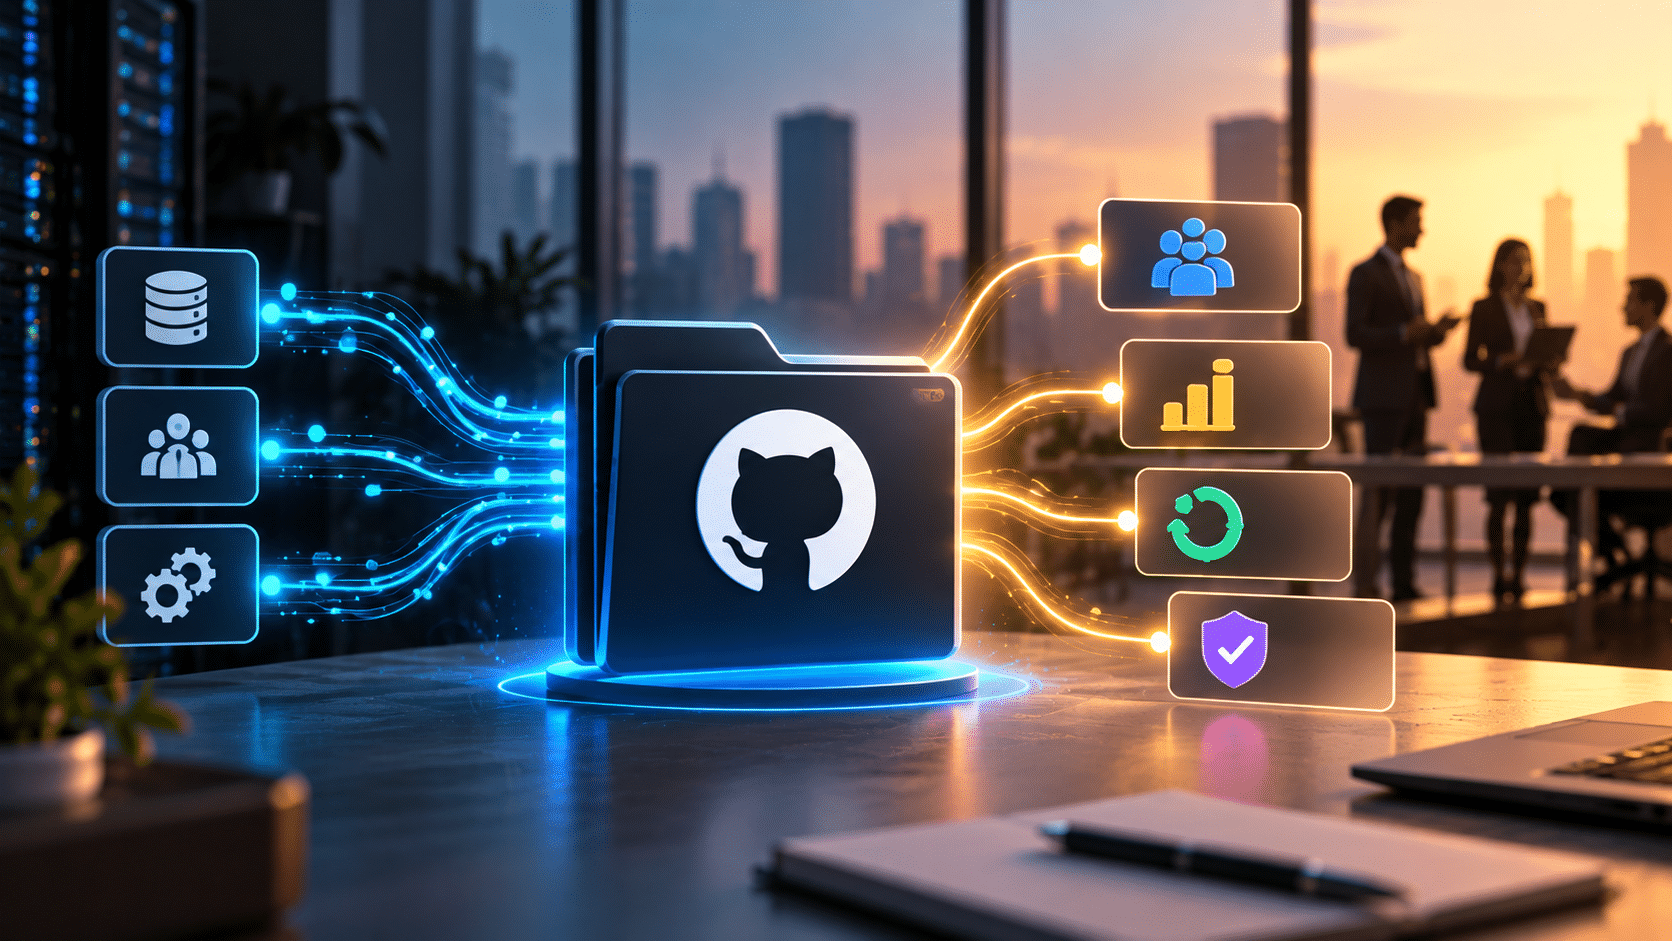
Un repository contiene il codice sorgente, la cronologia delle modifiche, i branch di sviluppo, le configurazioni e la documentazione di un progetto software. Dal punto di vista tecnico, queste informazioni mostrano come è stato costruito un sistema e come cambia nel tempo.
Tuttavia, il codice non spiega sempre che cosa rappresenta il sistema per l’organizzazione.
Il nome di un repository potrebbe non indicare quale team ne sia responsabile, quanto sia critico il servizio, in quale fase del proprio ciclo di vita si trovi o quali requisiti di conformità debba rispettare. Queste informazioni possono essere presenti in una CMDB, in un portale interno per sviluppatori, nella documentazione o in altri sistemi dell’organizzazione.
Quando il contesto tecnico e quello aziendale sono archiviati in luoghi diversi, diventa più difficile ottenere una visione completa del software.
Il 29 settembre 2026, GitHub ha introdotto le external custom properties, una funzionalità disponibile in anteprima pubblica che consente alle organizzazioni di trasferire in GitHub il contesto aziendale proveniente da un sistema esterno. Informazioni come la proprietà, il livello del servizio, la fase del ciclo di vita e lo stato di conformità possono essere sincronizzate con i repository, mentre il sistema esterno continua a rimanere la fonte ufficiale dei dati.
Un repository non è soltanto uno spazio per il codice
In molte organizzazioni, i repository vengono considerati principalmente come unità tecniche. Contengono il codice e rappresentano i principali ambienti in cui gli sviluppatori collaborano, esaminano le modifiche e automatizzano i processi di test o distribuzione.
Tuttavia, lo stesso repository fa anche parte di un sistema aziendale più ampio.
Può contenere il codice di un servizio che elabora pagamenti, gestisce dati personali, supporta un processo critico o viene utilizzato soltanto per un esperimento interno. Due repository possono avere strutture tecniche simili, ma livelli di importanza completamente diversi per l’organizzazione.
Senza questo contesto, un team può vedere il codice, ma non necessariamente l’impatto che quel codice produce.
Il contesto del repository aiuta a collegare il componente tecnico alla funzione che svolge all’interno dell’azienda.
La proprietà deve essere visibile
Una delle prime domande poste durante un incidente o una modifica è: quale team è responsabile di questo sistema?
In un’organizzazione con centinaia o migliaia di repository, la risposta non è sempre chiara. I team cambiano, i progetti vengono trasferiti e la documentazione potrebbe non essere aggiornata con la stessa rapidità della struttura organizzativa.
Quando la proprietà viene registrata come parte del contesto del repository, diventa più semplice identificare il team che deve esaminare una modifica, rispondere a un incidente o prendere una decisione architetturale.
Non si tratta soltanto di una questione organizzativa. Una proprietà chiaramente definita è direttamente collegata alla responsabilità.
Un repository privo di un proprietario identificabile può rimanere con dipendenze obsolete, vulnerabilità irrisolte o processi di distribuzione che nessuno controlla completamente.
Non tutti i servizi hanno lo stesso livello di importanza
Una modifica apportata a uno strumento interno sperimentale non ha lo stesso impatto di una modifica effettuata su un sistema di pagamento o autenticazione.
Se i repository vengono associati a informazioni sulla criticità del servizio, l’organizzazione può applicare politiche differenti in base al livello di rischio.
Un servizio critico può richiedere più approvazioni, controlli di sicurezza più approfonditi e procedure di distribuzione più rigorose. Un progetto con un impatto limitato può utilizzare un processo più semplice.
Senza il contesto aziendale, le piattaforme di sviluppo possono trattare quasi tutti i repository allo stesso modo. Grazie a questo contesto, la governance può essere adattata all’importanza effettiva di ciascun sistema.
La domanda non riguarda soltanto il superamento dei test da parte del codice. Bisogna anche chiedersi che cosa sia a rischio se la modifica non funziona.
Il ciclo di vita cambia il modo in cui viene gestito il software
Il software non rimane per sempre nella stessa fase.
Un progetto può essere in fase di sviluppo attivo, in produzione, in manutenzione limitata o prossimo alla dismissione. Ogni fase richiede decisioni differenti riguardo agli investimenti, alla sicurezza e alle modifiche tecniche.
Se la fase del ciclo di vita è visibile nel repository, i team possono comprendere meglio quale tipo di lavoro debba essere svolto.
Un sistema in fase di sviluppo attivo può accettare modifiche architetturali frequenti. Un sistema stabile e critico può richiedere maggiore cautela. Un repository prossimo alla dismissione non necessita necessariamente dello stesso livello di investimento di una piattaforma strategica.
Queste informazioni aiutano inoltre a evitare lavori non necessari. Un agente di IA o un processo automatizzato potrebbe proporre di modernizzare un progetto senza sapere che l’organizzazione ha deciso di sostituirlo entro pochi mesi.
Il contesto del ciclo di vita collega la decisione tecnica alla direzione a lungo termine del sistema.
La conformità deve far parte del processo tecnico
Alcuni repository contengono software che elabora dati personali, informazioni finanziarie o processi soggetti a specifici requisiti legali e di sicurezza.
In questi casi, lo stato di conformità non dovrebbe rimanere soltanto nella documentazione separata dal lavoro degli sviluppatori.
Se il contesto della conformità è collegato al repository, può essere utilizzato per il filtraggio, la creazione di report e l’applicazione delle politiche. I repository che elaborano dati sensibili possono essere identificati più facilmente e sottoposti a controlli più rigorosi.
GitHub spiega che le external custom properties possono essere utilizzate ovunque vengano già impiegate le custom properties esistenti, comprese le visualizzazioni dei repository, il filtraggio dei repository e la selezione degli obiettivi per i ruleset. Ciò significa che il contesto sincronizzato può influenzare direttamente la governance della piattaforma.
In questo modo, la conformità non è soltanto un controllo effettuato dopo lo sviluppo. Diventa parte del modo in cui il lavoro tecnico viene organizzato e controllato.
La fonte ufficiale dei dati deve rimanere chiara
Un problema comune nei sistemi aziendali è la duplicazione delle stesse informazioni su più piattaforme.
La proprietà di un servizio può essere registrata in una CMDB, in un portale per sviluppatori, nella documentazione e su GitHub. Se ogni sistema consente modifiche indipendenti, le informazioni possono diventare inesatte o contraddittorie.
Le external custom properties sono progettate per prevenire questo problema. I valori vengono gestiti dal sistema esterno e appaiono in sola lettura nell’interfaccia di GitHub. Gli utenti non possono modificarli direttamente in GitHub, mentre l’integrazione li aggiorna ogni volta che cambia la fonte ufficiale.
Questa separazione è importante. GitHub utilizza il contesto, ma non ne diventa necessariamente il proprietario.
Un sistema può continuare a gestire la struttura organizzativa, la proprietà e lo stato dei servizi, mentre la piattaforma di sviluppo utilizza queste informazioni per la ricerca, l’automazione e la governance.
La sincronizzazione è più importante della copia
Trasferire i dati da un sistema a un altro non è sufficiente se rimangono invariati dopo l’importazione iniziale.
Il contesto aziendale cambia continuamente. Un servizio può essere trasferito a un altro team, classificato come più critico o spostato dallo sviluppo attivo alla manutenzione.
Per questo motivo, l’integrazione deve garantire una sincronizzazione continua.
GitHub assegna alle external custom properties uno spazio dei nomi dedicato, in modo che i dati gestiti da un’integrazione possano essere distinti da quelli provenienti da altre fonti. Le organizzazioni possono creare le proprie integrazioni tramite API e controllare l’accesso con autorizzazioni granulari.
Questo trasforma il contesto del repository da etichetta statica a rappresentazione aggiornata della realtà organizzativa.
Il contesto può guidare l’automazione
Quando le informazioni aziendali diventano disponibili sulla piattaforma in cui viene sviluppato il software, possono essere utilizzate per molto più che semplici ricerche manuali.
Un’organizzazione può applicare politiche differenti in base alla proprietà, alla criticità o allo stato di conformità. I repository critici possono richiedere controlli di sicurezza aggiuntivi. I progetti alla fine del proprio ciclo di vita possono essere limitati alle correzioni essenziali. I sistemi regolamentati possono richiedere l’approvazione di ruoli specifici.
In questo modo, un’informazione aziendale può influenzare una decisione tecnica automatizzata.
Ciò rende la governance più precisa. Le politiche non vengono applicate soltanto in base al nome del repository o all’organizzazione in cui si trova, ma in base al ruolo effettivo che svolge nel sistema.
Gli agenti di IA hanno bisogno di più del codice
L’importanza del contesto aumenta ulteriormente quando gli agenti di IA iniziano ad analizzare e modificare i repository.
Un agente può comprendere la struttura del codice, identificare le dipendenze e proporre una modifica tecnica. Tuttavia, basandosi soltanto sul codice, potrebbe non capire che il sistema è critico, elabora dati sensibili o è destinato alla dismissione.
Senza queste informazioni, la soluzione può essere tecnicamente corretta, ma inadatta alle esigenze aziendali.
Il contesto del repository può aiutare gli agenti ad adattare il proprio modo di operare. Un’attività relativa a un servizio critico può richiedere più verifiche e l’approvazione umana. Un repository sperimentale può consentire una maggiore autonomia.
L’IA non dovrebbe comprendere soltanto il codice che sta modificando. Dovrebbe anche comprendere l’importanza e i limiti del sistema in cui sta operando.
Il contesto non deve trasformarsi in metadati incontrollati
L’aggiunta di una maggiore quantità di dati non garantisce automaticamente una governance migliore.
Se un’organizzazione crea troppi campi senza definirne il significato e la proprietà, il contesto può diventare difficile da utilizzare. Le etichette possono rimanere vuote, essere utilizzate in modo differente dai vari team o non essere aggiornate.
Le external custom properties dovrebbero quindi basarsi su un modello di dati chiaro.
L’organizzazione deve definire quali informazioni siano realmente necessarie, quale sistema ne costituisca la fonte ufficiale e chi sia responsabile della loro accuratezza. Deve inoltre essere chiaro quali politiche dipendano da ciascun valore.
L’obiettivo non è riempire i repository di metadati. L’obiettivo è garantire che le decisioni tecniche siano supportate da un contesto accurato e utilizzabile.
L’architettura tecnica e la realtà aziendale devono essere collegate
Per ALSoft, le external custom properties dimostrano un cambiamento importante nel modo in cui le organizzazioni possono gestire i propri ecosistemi software.
Un repository non dovrebbe essere considerato soltanto come il luogo in cui viene archiviato il codice. È un componente dell’architettura aziendale e deve essere collegato alla proprietà, al servizio, al rischio e ai requisiti aziendali che rappresenta.
Come spiega Ermal Beqiri, fondatore di ALSoft:
«Il codice può mostrare come funziona un sistema, ma non sempre spiega perché quel sistema sia importante per l’organizzazione. Quando un repository è collegato alla proprietà, alla criticità del servizio, alla fase del ciclo di vita e ai requisiti di conformità, le decisioni tecniche acquisiscono il contesto di cui hanno bisogno. Questo è il passaggio che collega lo sviluppo del software alla reale governance aziendale.»
I repository stanno gradualmente diventando più di semplici raccolte di file e cronologie delle modifiche. Si stanno trasformando in punti in cui convergono codice, proprietà, politiche e responsabilità organizzativa.
Questo collegamento può migliorare il modo in cui i team cercano informazioni, gestiscono i rischi, automatizzano le politiche e dirigono gli agenti di IA.
Il codice rimane la base tecnica del sistema. Ma per gestire il software come parte dell’azienda, il repository deve comprendere anche il contesto che lo circonda.