Votre panier est vide.
Le code ne suffit pas : pourquoi les dépôts doivent-ils aussi comprendre le contexte métier ?
30 Sep
Un dépôt contient le code source, l’historique des modifications, les branches de développement, les configurations et la documentation d’un projet logiciel. D’un point de vue technique, ces informations montrent comment un système a été construit et comment il évolue.
Cependant, le code n’explique pas toujours ce que le système représente pour l’organisation.
Le nom d’un dépôt peut ne pas indiquer quelle équipe en est responsable, à quel point le service est critique, à quelle étape de son cycle de vie il se trouve ou quelles exigences de conformité il doit respecter. Ces informations peuvent exister dans une CMDB, un portail interne pour les développeurs, une documentation ou d’autres systèmes de l’organisation.
Lorsque le contexte technique et le contexte métier sont stockés à différents endroits, il devient plus difficile d’obtenir une vision complète du logiciel.
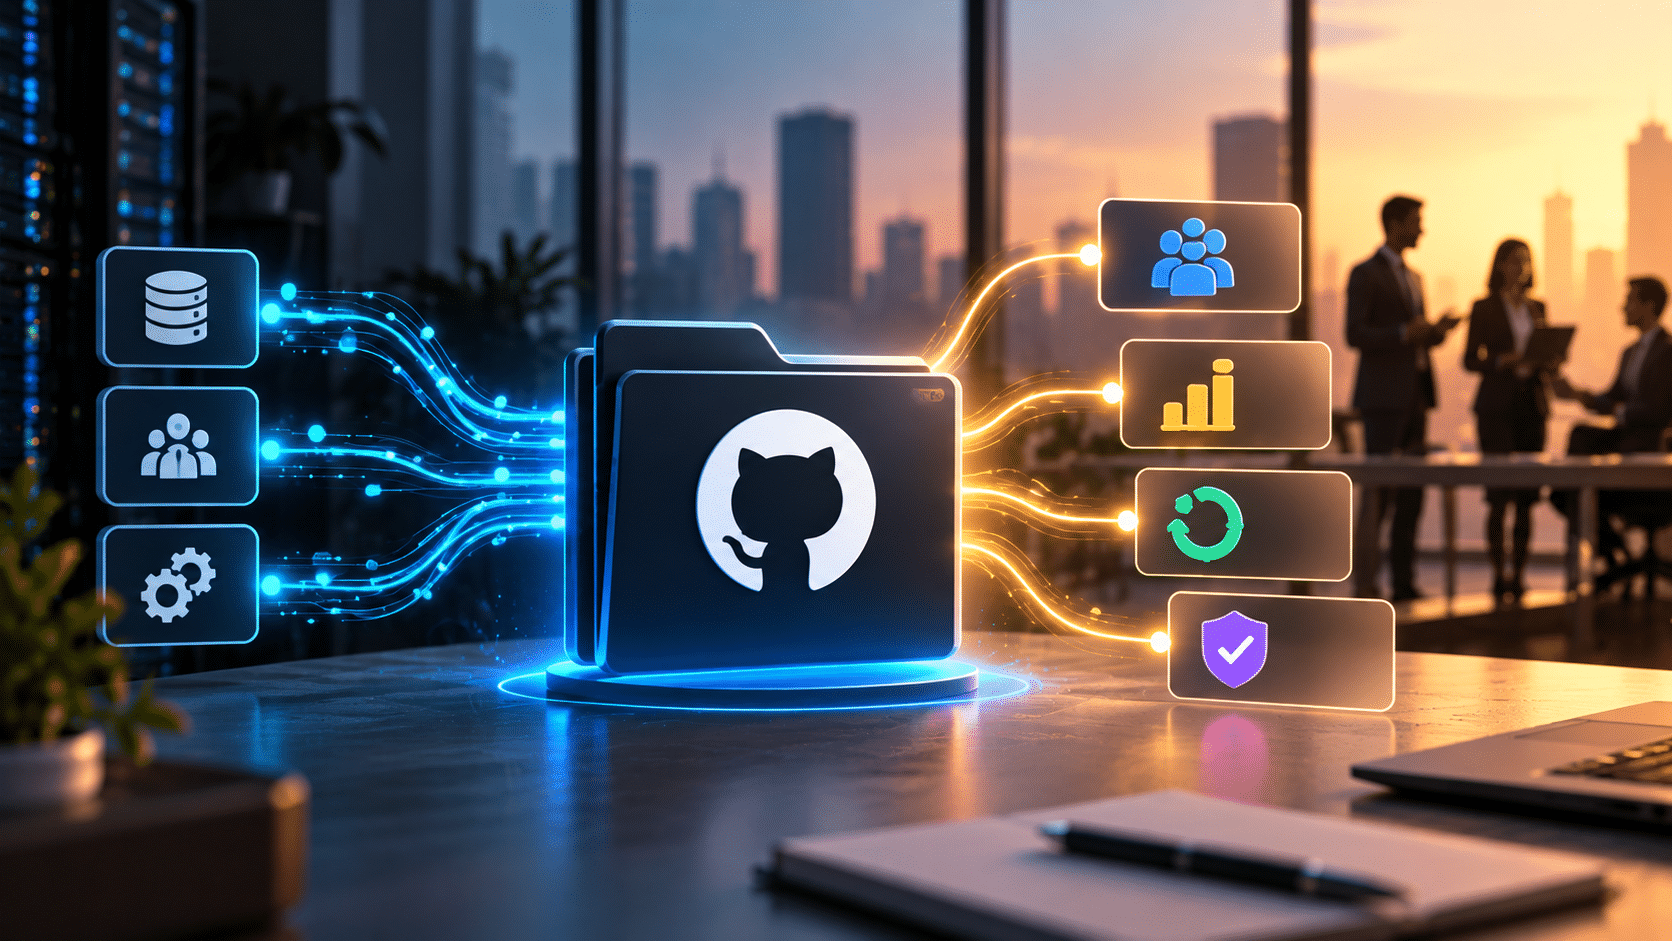
Le 29 septembre 2026, GitHub a présenté les external custom properties, une fonctionnalité disponible en préversion publique qui permet d’intégrer dans GitHub le contexte métier provenant d’un système externe. Des informations telles que la propriété, le niveau de service, l’étape du cycle de vie et le statut de conformité peuvent être synchronisées avec les dépôts, tandis que le système externe continue de constituer la source officielle des données.
Un dépôt n’est pas seulement un espace destiné au code
Dans de nombreuses organisations, les dépôts sont principalement considérés comme des unités techniques. Ils contiennent le code et constituent les principaux espaces dans lesquels les développeurs collaborent, examinent les modifications et automatisent les processus de test ou de déploiement.
Cependant, ce même dépôt fait également partie d’un système métier plus large.
Il peut contenir le code d’un service qui traite des paiements, gère des données personnelles, soutient un processus critique ou sert uniquement à une expérimentation interne. Deux dépôts peuvent avoir des structures techniques similaires tout en présentant des niveaux d’importance totalement différents pour l’organisation.
Sans ce contexte, une équipe peut voir le code, mais pas nécessairement les répercussions de ce code.
Le contexte du dépôt permet de relier le composant technique à la fonction qu’il remplit au sein de l’entreprise.
La propriété doit être visible
L’une des premières questions posées lors d’un incident ou d’une modification est la suivante : quelle équipe est responsable de ce système ?
Dans une organisation qui compte des centaines ou des milliers de dépôts, la réponse n’est pas toujours claire. Les équipes changent, les projets sont transférés et la documentation peut ne pas être mise à jour aussi rapidement que la structure organisationnelle.
Lorsque la propriété est enregistrée dans le contexte du dépôt, il devient plus facile d’identifier l’équipe qui doit examiner une modification, répondre à un incident ou prendre une décision architecturale.
Il ne s’agit pas seulement d’une question d’organisation. Une propriété clairement définie est directement liée à la responsabilité.
Un dépôt sans propriétaire identifiable peut conserver des dépendances obsolètes, des vulnérabilités non résolues ou des processus de déploiement que personne ne contrôle entièrement.
Tous les services n’ont pas le même niveau d’importance
Une modification apportée à un outil interne expérimental n’a pas les mêmes conséquences qu’une modification effectuée dans un système de paiement ou d’authentification.
Si les dépôts sont associés à des informations sur la criticité du service, l’organisation peut appliquer différentes politiques en fonction du niveau de risque.
Un service critique peut exiger davantage d’approbations, des contrôles de sécurité plus approfondis et des procédures de déploiement plus strictes. Un projet dont l’impact est limité peut utiliser un processus plus simple.
Sans contexte métier, les plateformes de développement peuvent traiter presque tous les dépôts de la même manière. Grâce à ce contexte, la gouvernance peut être adaptée à l’importance réelle de chaque système.
La question n’est pas seulement de savoir si le code réussit les tests. Il faut également se demander ce qui est menacé si la modification échoue.
Le cycle de vie modifie la manière dont le logiciel est géré
Un logiciel ne reste pas éternellement dans la même phase.
Un projet peut être en cours de développement actif, en production, en maintenance limitée ou proche de son retrait. Chaque phase nécessite des décisions différentes concernant les investissements, la sécurité et les modifications techniques.
Si l’étape du cycle de vie est visible dans le dépôt, les équipes peuvent mieux comprendre le type de travail qui doit être réalisé.
Un système en développement actif peut accepter des modifications architecturales fréquentes. Un système stable et critique peut exiger davantage de prudence. Un dépôt proche de son retrait ne nécessite pas forcément le même investissement qu’une plateforme stratégique.
Ces informations permettent également d’éviter les travaux inutiles. Un agent d’IA ou un processus automatisé peut proposer de moderniser un projet sans savoir que l’organisation a décidé de le remplacer dans quelques mois.
Le contexte du cycle de vie relie la décision technique à l’orientation à long terme du système.
La conformité doit faire partie du processus technique
Certains dépôts contiennent des logiciels qui traitent des données personnelles, des informations financières ou des processus soumis à des exigences juridiques et de sécurité spécifiques.
Dans ces cas, le statut de conformité ne doit pas rester uniquement dans une documentation séparée du travail des développeurs.
Si le contexte de conformité est associé au dépôt, il peut être utilisé pour le filtrage, la production de rapports et l’application des politiques. Les dépôts qui traitent des données sensibles peuvent être identifiés plus facilement et soumis à des contrôles plus stricts.
GitHub explique que les external custom properties peuvent être utilisées partout où les custom properties existantes sont déjà exploitées, notamment dans les vues des dépôts, le filtrage des dépôts et le ciblage des ensembles de règles. Cela signifie que le contexte synchronisé peut influencer directement la gouvernance de la plateforme.
De cette manière, la conformité ne constitue pas seulement un contrôle réalisé après le développement. Elle devient une composante de l’organisation et du contrôle du travail technique.
La source officielle des données doit rester clairement définie
La duplication des mêmes informations sur plusieurs plateformes constitue un problème courant dans les systèmes d’entreprise.
La propriété d’un service peut être enregistrée dans une CMDB, un portail pour les développeurs, la documentation et GitHub. Si chaque système autorise des modifications indépendantes, les informations peuvent devenir inexactes ou contradictoires.
Les external custom properties sont conçues pour éviter ce problème. Les valeurs sont gérées par le système externe et apparaissent en lecture seule dans l’interface de GitHub. Les utilisateurs ne peuvent pas les modifier directement dans GitHub, tandis que l’intégration les met à jour lorsque la source officielle évolue.
Cette séparation est importante. GitHub utilise le contexte, mais n’en devient pas nécessairement le propriétaire.
Un système peut continuer à gérer la structure organisationnelle, la propriété et le statut des services, tandis que la plateforme de développement utilise ces informations pour la recherche, l’automatisation et la gouvernance.
La synchronisation est plus importante que la copie
Le transfert de données d’un système vers un autre ne suffit pas si elles restent inchangées après leur importation initiale.
Le contexte métier évolue continuellement. Un service peut être transféré à une autre équipe, être classé comme plus critique ou passer du développement actif à la maintenance.
Pour cette raison, l’intégration doit assurer une synchronisation continue.
GitHub attribue aux external custom properties un espace de noms dédié afin que les données gérées par une intégration puissent être distinguées de celles provenant d’autres sources. Les organisations peuvent créer leurs propres intégrations à l’aide des API et contrôler les accès grâce à des autorisations précises.
Cela transforme le contexte du dépôt, qui n’est plus une étiquette statique, mais une représentation actualisée de la réalité organisationnelle.
Le contexte peut orienter l’automatisation
Lorsque les informations métier deviennent disponibles sur la plateforme où le logiciel est développé, elles peuvent servir à bien plus que des recherches manuelles.
Une organisation peut appliquer différentes politiques selon la propriété, la criticité ou le statut de conformité. Les dépôts critiques peuvent exiger des contrôles de sécurité supplémentaires. Les projets arrivés à la fin de leur cycle de vie peuvent être limités aux corrections essentielles. Les systèmes réglementés peuvent nécessiter l’approbation de rôles spécifiques.
De cette manière, une information métier peut influencer une décision technique automatisée.
Cela rend la gouvernance plus précise. Les politiques ne sont pas seulement appliquées en fonction du nom du dépôt ou de l’organisation dans laquelle il se trouve, mais selon le rôle réel qu’il joue dans le système.
Les agents d’IA ont besoin de davantage que du code
L’importance du contexte devient encore plus grande lorsque les agents d’IA commencent à analyser et à modifier les dépôts.
Un agent peut comprendre la structure du code, identifier les dépendances et proposer une modification technique. Cependant, à partir du code uniquement, il peut ne pas comprendre que le système est critique, qu’il traite des données sensibles ou que son retrait est planifié.
Sans ces informations, la solution peut être techniquement correcte, mais inadaptée aux besoins de l’entreprise.
Le contexte du dépôt peut aider les agents à adapter leur manière d’agir. Une tâche concernant un service critique peut nécessiter davantage de vérifications et une approbation humaine. Un dépôt expérimental peut permettre une plus grande autonomie.
L’IA ne doit pas seulement comprendre le code qu’elle modifie. Elle doit également comprendre l’importance et les limites du système dans lequel elle intervient.
Le contexte ne doit pas devenir un ensemble de métadonnées incontrôlées
L’ajout de davantage de données ne garantit pas automatiquement une meilleure gouvernance.
Si une organisation crée trop de champs sans définir leur signification et leur propriété, le contexte peut devenir difficile à exploiter. Certaines étiquettes peuvent rester vides, être utilisées différemment selon les équipes ou ne pas être mises à jour.
Les external custom properties doivent donc s’appuyer sur un modèle de données clairement défini.
L’organisation doit déterminer quelles informations sont réellement nécessaires, quel système constitue leur source officielle et qui est responsable de leur exactitude. Il doit également être clair quelles politiques dépendent de chaque valeur.
L’objectif n’est pas de remplir les dépôts de métadonnées. Il est de garantir que les décisions techniques reposent sur un contexte précis et exploitable.
L’architecture technique et la réalité de l’entreprise doivent être reliées
Pour ALSoft, les external custom properties témoignent d’un changement important dans la manière dont les organisations peuvent gérer leur écosystème logiciel.
Un dépôt ne doit pas être considéré uniquement comme l’endroit où le code est stocké. Il constitue un composant de l’architecture d’entreprise et doit être relié à la propriété, au service, au risque et aux exigences métier qu’il représente.
Comme l’explique Ermal Beqiri, fondateur de ALSoft :
« Le code peut montrer comment un système fonctionne, mais il n’explique pas toujours pourquoi ce système est important pour l’organisation. Lorsqu’un dépôt est associé à la propriété, à la criticité du service, à l’étape du cycle de vie et aux exigences de conformité, les décisions techniques acquièrent le contexte dont elles ont besoin. C’est cette étape qui relie le développement logiciel à la véritable gouvernance de l’entreprise. »
Les dépôts deviennent progressivement bien plus que des collections de fichiers et d’historiques de modifications. Ils se transforment en points de rencontre entre le code, la propriété, les politiques et la responsabilité organisationnelle.
Cette connexion peut améliorer la manière dont les équipes recherchent des informations, gèrent les risques, automatisent les politiques et dirigent les agents d’IA.
Le code reste la base technique du système. Mais pour gérer le logiciel comme une composante de l’entreprise, le dépôt doit également comprendre le contexte qui l’entoure.