Votre panier est vide.
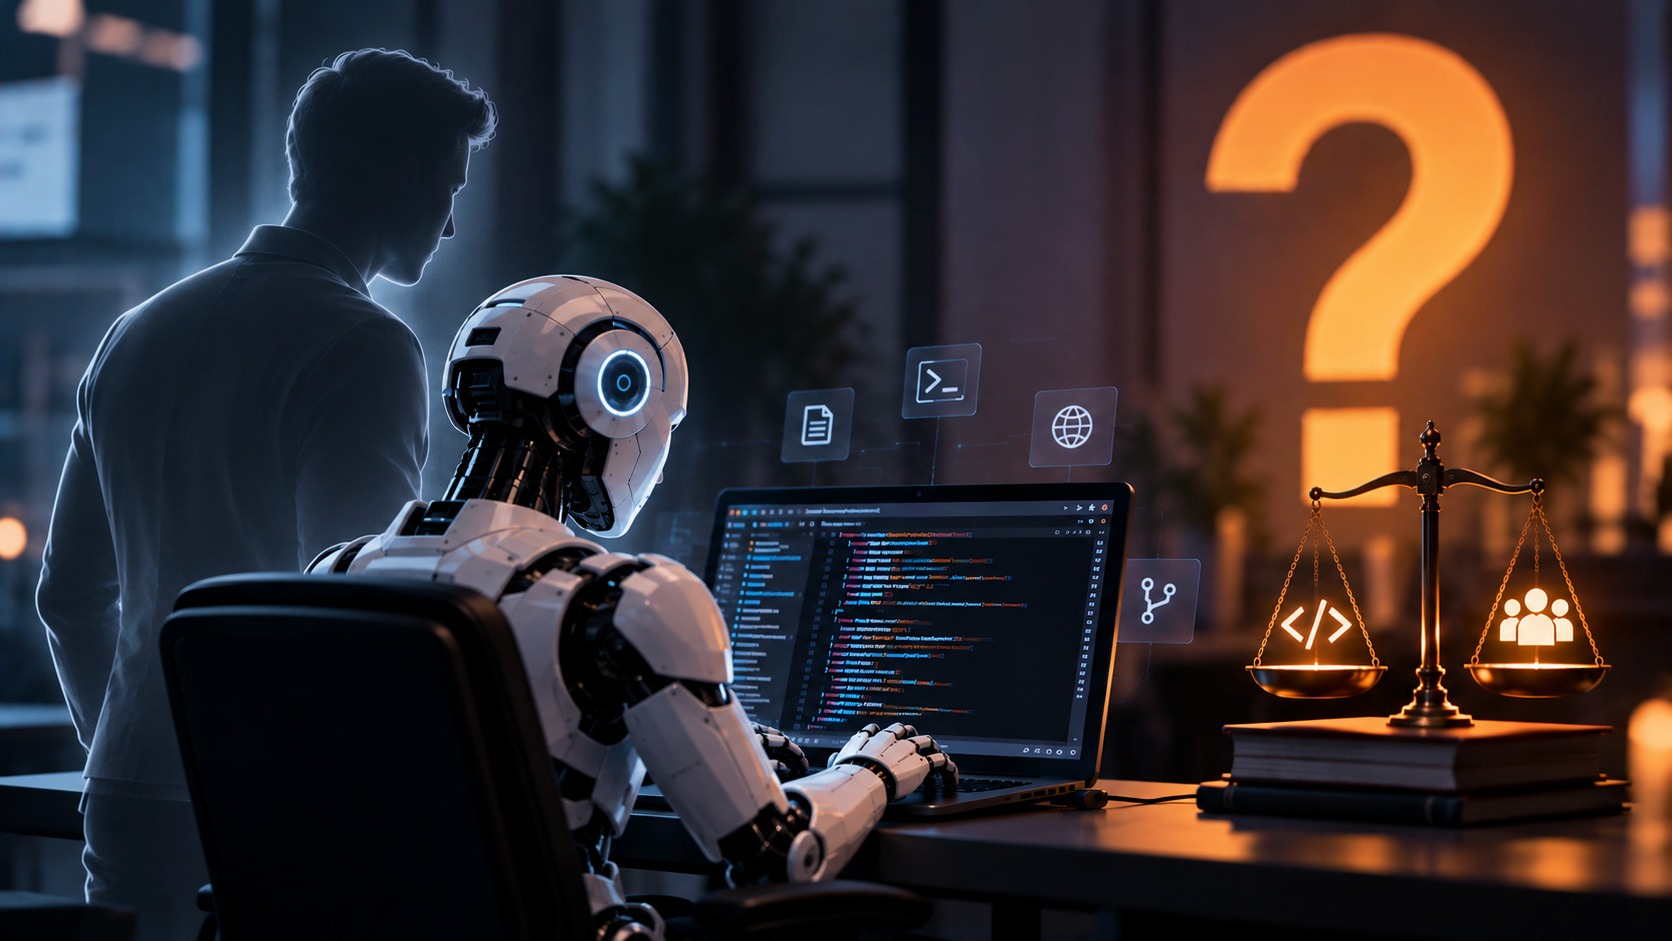
L’IA écrit le code, mais qui est responsable lorsqu’il échoue ?
06 Oct
Depuis des décennies, la responsabilité dans le développement logiciel est relativement claire.
Le développeur écrit le code. L’équipe le révise. Les tests vérifient qu’il fonctionne. L’organisation décide si le logiciel est prêt à être déployé en production.
Mais l’IA est en train de modifier l’un des maillons les plus fondamentaux de ce processus.
Aujourd’hui, un agent de codage ne se limite plus à suggérer quelques lignes de code.
Il peut analyser un dépôt, identifier un problème, modifier plusieurs fichiers, développer une fonctionnalité, exécuter des tests et proposer une implémentation presque complète.
Selon le rapport The 2026 State of AI Agents d’Anthropic, plus de 9 organisations interrogées sur 10 utilisent l’IA pour les assister dans le codage. 86 % utilisent des agents de codage pour du code destiné à être mis en production, tandis que 42 % font confiance à ces agents pour diriger le travail de développement, les humains continuant à réviser le code et à définir la stratégie.
Cela soulève une question à laquelle l’industrie du logiciel devra de plus en plus répondre :
Si l’IA écrit la majeure partie du code, qui est responsable lorsque ce code échoue ?
De « L’IA m’a aidé » à « L’IA l’a implémenté »
Aux premiers stades du codage assisté par l’IA, la répartition des responsabilités était plus simple.
Le développeur écrivait le code, tandis que l’IA suggérait une fonction, complétait quelques lignes ou expliquait une erreur.
La prise de décision et l’implémentation restaient principalement humaines.
Les agents de codage sont en train de transformer cette relation.
Un développeur peut donner à un agent un objectif général et lui permettre de déterminer de manière autonome une partie de l’approche d’implémentation.
L’étude d’Anthropic portant sur environ 400 000 sessions Claude Code montre précisément cette répartition : les humains ont tendance à prendre davantage de décisions concernant ce qui doit être fait, tandis que l’IA prend davantage de décisions concernant la manière dont cela doit être fait.
Dans ce modèle, le développeur n’est pas nécessairement l’auteur de chaque ligne de code.
Mais il reste partie prenante du processus qui détermine si ce code doit être accepté.
L’auteur du code et la personne qui en assume la responsabilité ne sont pas nécessairement les mêmes
Une distinction importante doit être faite ici.
Qui a généré le code ?
et
Qui est responsable de son déploiement en production ?
sont deux questions différentes.
Un agent de codage peut générer l’implémentation.
Mais c’est l’organisation qui décide quels outils d’IA sont utilisés, à quoi ils ont accès, quelles normes le code doit respecter et à quel moment une approbation humaine est requise.
Par conséquent, l’utilisation de l’IA ne devrait pas créer un vide en matière de responsabilité.
Au contraire, elle exige que les responsabilités soient définies encore plus clairement.
« C’est l’IA qui l’a écrit » ne peut pas devenir un mécanisme de transfert de responsabilité
Imaginons qu’un agent de codage crée une nouvelle fonctionnalité.
Les tests réussissent.
Le code semble propre.
Le développeur l’approuve et la modification est mise en production.
Plus tard, un problème sérieux est découvert.
Dans un modèle traditionnel, l’équipe peut analyser les décisions techniques qui ont conduit à l’erreur ainsi que le processus de revue de code qui n’a pas permis de l’identifier.
Dans un flux de travail piloté par l’IA, une nouvelle réponse peut apparaître :
« C’est l’IA qui a écrit cette partie. »
Mais cela ne résout pas le problème.
Si une organisation a choisi d’utiliser l’IA pour implémenter des logiciels, elle doit également mettre en place les processus nécessaires pour vérifier les résultats qu’elle produit.
L’IA peut changer la manière dont le code est produit.
Elle ne devrait pas supprimer la responsabilité concernant la manière dont ce code est vérifié et utilisé.
Le Human-in-the-Loop prend une nouvelle signification
Selon le rapport d’Anthropic, 42 % des organisations déclarent faire confiance aux agents de codage pour diriger le développement, tandis que les humains restent impliqués dans la revue du code et la définition de la stratégie.
Cette expression — human-in-the-loop — devient de plus en plus importante.
Mais le simple fait qu’un humain soit impliqué dans le processus ne suffit pas.
Si l’IA génère des milliers de lignes de code et qu’un développeur se contente de cliquer sur « Approuver », une supervision humaine existe techniquement, mais elle peut ne pas exister de manière significative dans la pratique.
La question ne devrait donc pas seulement être :
« Un humain l’a-t-il approuvé ? »
Elle devrait être :
« Cette personne disposait-elle des informations, du temps et de l’expertise nécessaires pour évaluer correctement la modification ? »
Plus l’IA produit de code, plus il devient difficile de tout réviser
L’IA crée un nouveau paradoxe pour les équipes de développement logiciel.
Les agents de codage peuvent considérablement augmenter la vitesse à laquelle le code est produit.
Mais la vitesse de la revue humaine du code n’augmente pas automatiquement au même rythme.
Si une équipe produisait auparavant dix modifications par jour et que l’IA lui permet désormais d’en produire beaucoup plus, examiner manuellement chaque modification avec le même niveau de profondeur devient de plus en plus difficile.
Anthropic anticipe précisément ce type de transformation : la supervision humaine pourrait progressivement passer de l’examen de chaque résultat à une concentration sur les cas où le jugement humain est réellement nécessaire.
Cela signifie que le système lui-même doit devenir plus performant dans l’identification des risques.
L’IA peut réviser l’IA, mais la responsabilité ne disparaît pas
Une solution émergente consiste à utiliser l’IA pour examiner les résultats produits par d’autres systèmes d’IA.
Un agent peut écrire le code.
Un autre peut le réviser.
Un système de sécurité peut rechercher des vulnérabilités.
Des tests automatisés peuvent vérifier le comportement.
Un autre mécanisme peut signaler uniquement les modifications à haut risque afin qu’un développeur les examine.
Cela peut rendre la supervision beaucoup plus évolutive.
Mais cela soulève également une autre question :
Si une IA écrit le code et qu’une autre IA l’approuve, qui contrôle le système de contrôle ?
En définitive, il doit exister un niveau auquel la responsabilité revient à l’organisation et aux personnes qui définissent les règles régissant le système.
La responsabilité se déplace de la ligne de code vers le système de développement
Il pourrait s’agir de l’un des changements les plus importants que l’IA apporte à l’ingénierie logicielle.
Dans le modèle traditionnel, le développeur était très proche de chaque ligne de code qu’il produisait.
Dans un modèle construit autour des agents de codage, le développeur peut être davantage éloigné de l’implémentation directe.
Sa responsabilité évolue vers la conception du processus :
Que peut-on déléguer à l’IA ?
Que faut-il vérifier automatiquement ?
Quelles modifications nécessitent une revue humaine du code ?
Quand l’agent doit-il s’arrêter et demander de l’aide ?
Quels tests doivent réussir avant qu’une modification puisse être acceptée ?
Quelles parties du système sont considérées comme trop critiques pour être entièrement déléguées à un agent ?
Ces questions deviennent des enjeux d’architecture logicielle et de gouvernance de l’ingénierie.
L’expertise humaine ne devient pas moins importante
On pourrait penser que plus l’IA devient performante dans l’écriture de code, moins les développeurs auront besoin d’expertise technique.
Les données d’Anthropic suggèrent une réalité plus complexe.
Dans son analyse d’environ 400 000 sessions Claude Code, les utilisateurs disposant d’une plus grande expertise dans le domaine concerné étaient plus susceptibles de mener les tâches à bien.
Cela paraît logique.
Pour examiner une implémentation, il faut comprendre comment le système doit se comporter.
Pour identifier une mauvaise décision architecturale, il faut comprendre l’architecture.
Et pour savoir quand ne pas faire confiance à un résultat généré par l’IA, il faut disposer de l’expertise nécessaire pour le remettre en question.
L’IA peut donc réduire la quantité de code qu’un développeur écrit manuellement, tout en augmentant l’importance du jugement technique.
La traçabilité deviendra aussi importante que la revue de code
Dans un système où l’IA participe à l’implémentation, les équipes doivent comprendre comment une modification a été créée.
Quel agent l’a proposée ?
Quelles instructions a-t-il reçues ?
Quels outils a-t-il utilisés ?
Quels tests a-t-il exécutés ?
Quel développeur l’a révisée ?
Quels contrôles automatisés a-t-elle passés ?
Cela crée une nouvelle forme de traçabilité logicielle.
Il ne suffit plus de savoir uniquement ce qui a changé dans le code.
De plus en plus, nous pourrions également avoir besoin de savoir comment et par qui les décisions ayant conduit à cette modification ont été prises.
De la propriété du code à la gouvernance de l’IA
De nombreuses équipes de développement logiciel utilisent déjà le concept de propriété du code.
Une équipe ou un développeur est responsable d’une partie spécifique du système.
Les agents de codage ne devraient pas supprimer ce modèle.
Ils pourraient même le rendre encore plus important.
Un dépôt peut contenir des milliers de lignes de code générées par l’IA, mais la responsabilité humaine du système doit toujours exister.
Quelqu’un doit définir les normes.
Quelqu’un doit établir les limites de l’autonomie.
Quelqu’un doit analyser les incidents.
Et quelqu’un doit avoir l’autorité nécessaire pour décider qu’une modification produite par l’IA ne doit pas être déployée en production.
La responsabilité du code IA devient une composante de l’architecture logicielle
Pour ALSoft, la question de savoir qui a écrit une ligne de code particulière deviendra progressivement moins importante que celle de savoir comment ce code a été vérifié avant de devenir une partie du système.
Les organisations qui utilisent des agents de codage doivent concevoir non seulement la manière dont l’IA produit le code, mais aussi la manière dont ce code est testé, révisé, approuvé et tracé.
Cela signifie que la responsabilité ne peut pas être une discussion qui commence uniquement après qu’un incident s’est produit.
Elle doit être intégrée dès le départ dans l’architecture du processus de développement.
Comme l’explique Ermal Beqiri, fondateur d’ALSoft :
« L’IA peut prendre en charge une part croissante de l’implémentation, mais la responsabilité ne peut pas être déléguée à un modèle. Si une organisation décide de faire confiance à l’IA pour écrire du code, elle doit également mettre en place les mécanismes qui définissent qui le révise, qui l’approuve et qui assume la responsabilité du résultat. L’autonomie technique doit toujours s’accompagner d’une responsabilité humaine clairement définie. »
L’IA transforme la paternité du logiciel.
Une part croissante de l’implémentation peut être produite par des systèmes qui ne sont pas humains.
Mais cela ne signifie pas que la responsabilité doit devenir floue.
Bien au contraire.
Plus un agent de codage devient autonome, plus ses limites, son processus de vérification et la responsabilité humaine du résultat doivent être clairement définis.
À l’ère des agents de codage, la question ne sera plus simplement :
« Qui a écrit ce code ? »
La question la plus importante sera :
« Qui a décidé que ce code était suffisamment fiable pour être utilisé ? »