Votre panier est vide.
Un agent de codage est-il aussi sécurisé que le code qu’il écrit ?
05 Oct
Depuis des années, l’une des principales questions dans le développement logiciel est la suivante : le code est-il sécurisé ?
Les développeurs analysent les vulnérabilités, vérifient les dépendances, testent les applications et déterminent quels utilisateurs peuvent accéder aux différentes parties d’un système.
Mais l’introduction des agents de codage dans le processus de développement soulève une autre question.
L’agent qui écrit et exécute le code est-il aussi sécurisé que le logiciel que nous essayons de construire ?
Cette question devient de plus en plus importante à mesure que les agents IA passent de la suggestion de quelques lignes de code à l’exécution d’actions réelles dans les environnements de développement.
Un agent de codage peut lire des fichiers, modifier du code, exécuter des commandes, installer des dépendances, utiliser des outils et, dans certaines configurations, communiquer avec des services via le réseau.
À ce stade, la sécurité ne concerne plus uniquement le code produit par l’IA.
Elle concerne également l’environnement dans lequel l’IA est autorisée à opérer.
De l’assistant qui suggère du code à l’agent qui exécute des commandes
La première génération d’outils d’IA pour la programmation fonctionnait principalement comme un système de suggestions.
Le développeur écrivait du code et le modèle proposait des fonctions, des extraits de code ou des solutions possibles.
Les agents de codage sont en train de transformer ce modèle.
Un agent peut recevoir une tâche, analyser le dépôt, identifier les fichiers qui doivent être modifiés, modifier le code et exécuter des outils afin de vérifier le résultat.
GitHub décrit cette évolution de Copilot, qui passe d’un assistant intégré à l’éditeur à un partenaire de développement capable d’utiliser des outils, d’exécuter des commandes et de modifier des fichiers.
Plus un agent est capable d’effectuer d’actions, plus une question devient importante : à quoi est-il autorisé à accéder ?
Une erreur dans une réponse textuelle peut être corrigée avant d’être utilisée.
Une commande exécutée dans un système réel peut avoir des conséquences immédiates.
Un agent de codage doit être traité comme un utilisateur du système
D’un point de vue architectural, un agent de codage ne doit pas être considéré uniquement comme un modèle d’IA.
Il devient un acteur actif au sein du système.
S’il peut lire le système de fichiers, utiliser le terminal et communiquer via le réseau, il dispose alors d’une surface d’accès qui doit être contrôlée.
Cette approche est similaire à la manière dont les systèmes modernes traitent les utilisateurs et les services.
Une application ne doit pas donner à chaque utilisateur l’accès à toutes les ressources. De la même manière, un agent de codage ne doit pas automatiquement avoir accès à l’ensemble d’un ordinateur simplement parce qu’il doit modifier un dépôt.
Le principe devient simple :
L’agent ne doit disposer que des accès nécessaires pour accomplir sa tâche.
Il s’agit d’une application directe du principe du moindre privilège au développement assisté par l’IA.
La sandbox devient la nouvelle frontière de sécurité
Le 2 juin 2026, GitHub a présenté en public preview des sandboxes cloud et locales pour GitHub Copilot.
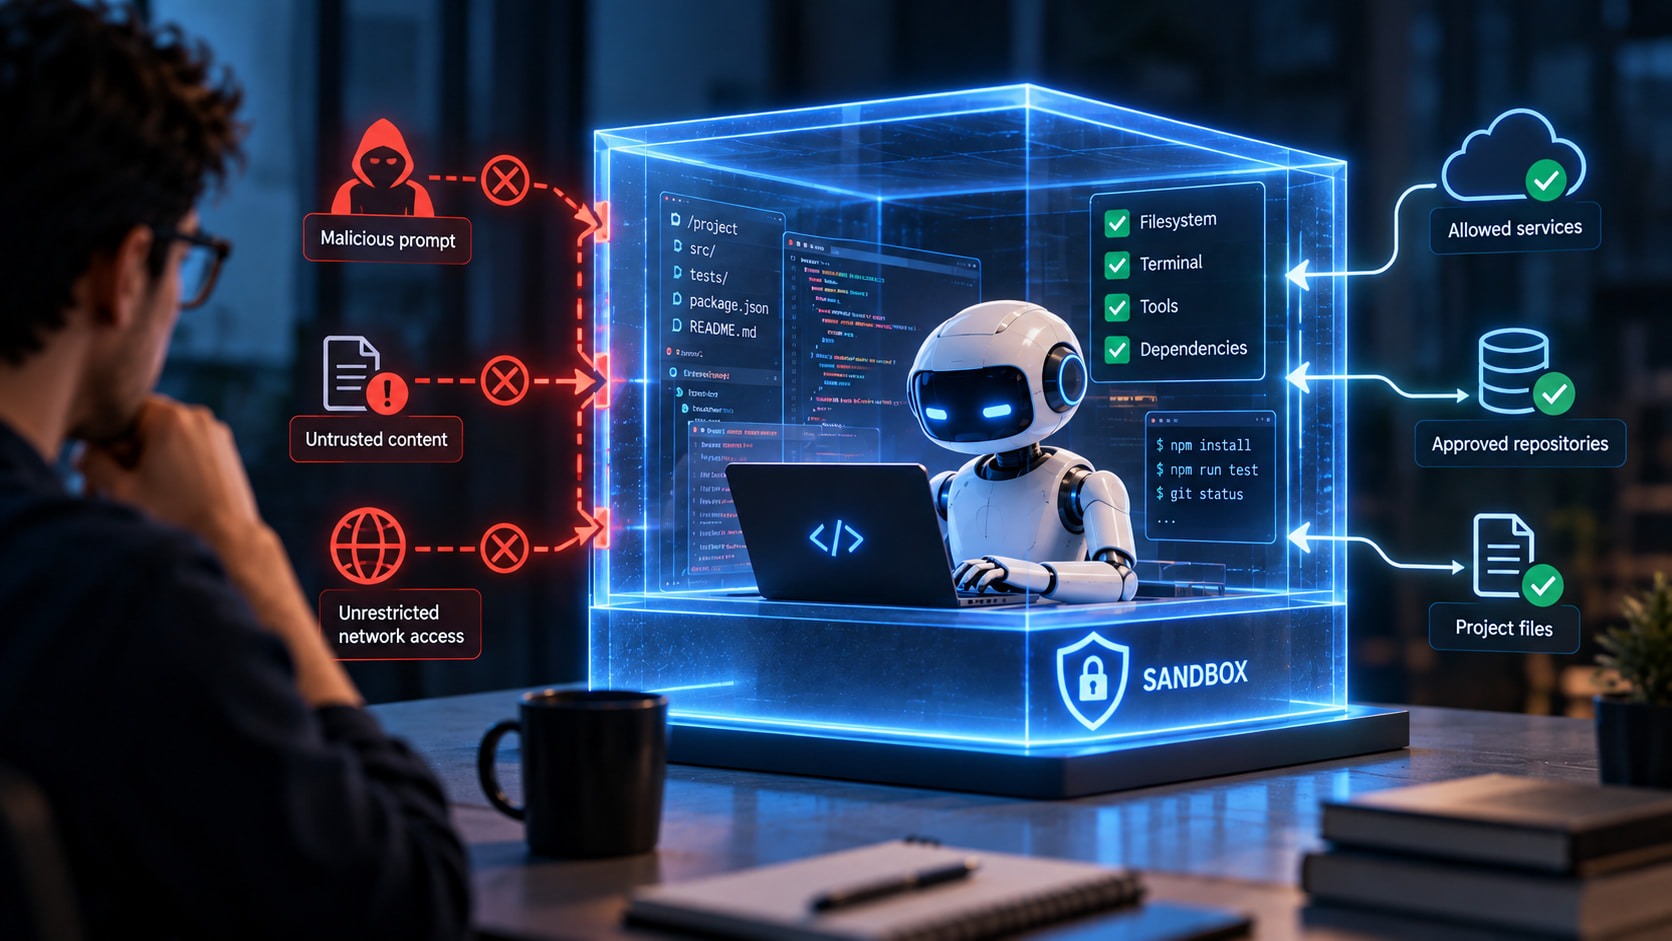
L’objectif est de permettre aux actions de Copilot de s’exécuter dans des environnements isolés, plutôt que d’accorder à l’agent un accès sans restriction au système sur lequel travaille le développeur.
Dans une sandbox locale, les commandes et les outils exécutés par l’agent peuvent disposer d’un accès restreint au système de fichiers, au réseau et aux fonctionnalités du système.
Une sandbox cloud va encore plus loin en déplaçant la session vers un environnement Linux temporaire et isolé, hébergé par GitHub.
Cela crée une séparation architecturale importante.
Au lieu de permettre à l’agent de codage d’exécuter chaque action directement sur le système principal, il est placé à l’intérieur d’une frontière où les ressources qu’il peut utiliser peuvent être définies.
Ainsi, la sandbox n’est pas simplement une fonctionnalité de sécurité supplémentaire.
Elle devient la couche d’exécution des agents de codage.
Le système de fichiers est l’une des frontières les plus importantes
Un agent de codage qui travaille sur un projet doit pouvoir lire et modifier des fichiers.
Mais cela ne signifie pas qu’il doit être capable de lire tous les fichiers présents sur l’appareil du développeur.
La documentation actuelle de GitHub permet de configurer l’accès de la sandbox au système de fichiers en fonction de chemins spécifiques. Certaines zones peuvent être accessibles en lecture et en écriture, d’autres uniquement en lecture, tandis que certaines peuvent être entièrement bloquées.
Cela permet de créer un modèle beaucoup plus contrôlé.
L’agent peut accéder au dépôt sur lequel il doit travailler sans nécessairement disposer de la même liberté dans le reste du système.
Cette distinction devient particulièrement importante lorsque l’appareil du développeur contient d’autres projets, configurations, identifiants ou données qui n’ont aucun rapport avec la tâche de l’agent.
Le réseau crée un autre problème : l’exfiltration des données
Le système de fichiers contrôle ce que l’agent peut lire ou modifier.
Le réseau contrôle où il peut envoyer des informations.
Un agent de codage peut avoir des raisons légitimes d’accéder à Internet. Il peut avoir besoin de télécharger une dépendance, de contacter un registre de packages ou d’utiliser un service nécessaire au processus de développement.
Mais un accès réseau sans restriction crée également des risques.
GitHub associe les restrictions d’accès à Internet à la gestion du risque d’exfiltration de données. Un comportement inattendu de l’agent ou des instructions malveillantes peuvent créer des situations dans lesquelles du code ou d’autres informations sensibles sont envoyés, ou font l’objet d’une tentative d’envoi, vers une destination externe.
Pour cette raison, l’agent cloud de Copilot utilise un pare-feu afin de limiter l’accès à Internet, et les organisations peuvent contrôler les destinations autorisées.
Cela déplace la question de sécurité de :
« Faisons-nous confiance au modèle ? »
vers une question plus pratique :
« Même si le modèle commet une erreur, que l’infrastructure lui permet-elle de faire ? »
La prompt injection n’est plus seulement un problème de chatbot
Un autre risque apparaît lorsque les agents reçoivent des instructions provenant de contenus qui ne sont pas entièrement contrôlés par le développeur.
GitHub avertit que le contenu présent dans les issues ou les commentaires peut être utilisé pour tenter une attaque par prompt injection contre l’agent cloud.
Ce point est particulièrement important pour les agents de codage, car ils ne produisent pas uniquement du texte.
Ils peuvent effectuer des actions.
Dans un système d’IA traditionnel, une instruction malveillante peut influencer la réponse du modèle.
Dans un système équipé d’outils, le même problème peut tenter d’influencer les commandes exécutées par l’agent, les fichiers qu’il lit ou les services avec lesquels il communique.
La protection ne peut donc pas reposer uniquement sur la capacité du modèle à distinguer les instructions sûres des instructions dangereuses.
Des limites techniques doivent exister en dehors du modèle.
Les identifiants doivent être considérés comme un privilège, et non comme un accès par défaut
Les identifiants figurent parmi les ressources les plus sensibles pouvant être confiées à un agent de codage.
Si un agent peut utiliser Git ou GitHub CLI avec l’identité du développeur, il peut potentiellement effectuer des actions qui vont au-delà de la simple modification d’un fichier local.
Pour cette raison, la configuration de la sandbox doit déterminer non seulement l’accès aux fichiers et au réseau, mais également les identifiants disponibles pendant l’exécution.
C’est une autre raison pour laquelle les agents de codage doivent être considérés comme des identités opérationnelles au sein de l’architecture.
La question ne doit pas seulement être « que sait l’agent ? », mais :
Que peut faire l’agent avec l’identité que nous lui avons attribuée ?
Une sandbox réduit les risques, mais ne les élimine pas
L’isolation constitue une couche de sécurité importante, mais elle ne doit pas être considérée comme une garantie absolue.
La documentation de GitHub elle-même souligne les limites du pare-feu et avertit que des attaques sophistiquées peuvent tenter de contourner ces protections.
De la même manière, un agent de codage peut générer un code qui semble correct mais qui contient des erreurs fonctionnelles ou des vulnérabilités de sécurité.
Cela signifie qu’il existe deux problèmes distincts.
Le premier concerne la sécurité du code produit par l’agent.
Le second concerne la sécurité des actions effectuées par l’agent pendant la production de ce code.
La sandbox contribue principalement à résoudre le second problème.
La revue de code, les tests, l’analyse statique et les contrôles de sécurité restent nécessaires pour traiter le premier.
La supervision humaine reste une composante du modèle de sécurité
L’autonomie des agents de codage ne doit pas signifier l’absence de supervision humaine.
GitHub recommande de vérifier les résultats produits par un agent avant de les intégrer à la base de code principale et applique des restrictions supplémentaires à l’agent cloud.
Par exemple, l’agent dispose d’un accès limité au dépôt, ne peut pas pousser directement des modifications vers la branche principale et certains workflows nécessitent une approbation humaine avant de pouvoir être exécutés.
Ces mesures illustrent un principe plus large pour l’architecture des systèmes d’IA :
L’autonomie doit progresser en même temps que le contrôle.
Plus un agent est capable d’effectuer d’actions, plus ses limites, ses autorisations, sa traçabilité et les points nécessitant une approbation humaine doivent être clairement définis.
La sécurité des agents de codage devient un problème architectural
Pour ALSoft, le développement avec des agents de codage doit être considéré comme un changement architectural, et non simplement comme l’adoption d’un nouvel outil de productivité.
À partir du moment où une IA peut utiliser le terminal, modifier des fichiers, communiquer via le réseau et fonctionner avec des identifiants, elle devient une composante active du modèle de sécurité du système.
Cela signifie que les équipes doivent définir les limites d’accès avant de définir le niveau d’autonomie.
Comme l’explique Ermal Beqiri, fondateur d’ALSoft :
« Un agent de codage ne devient pas sécurisé simplement parce que le modèle est avancé. La sécurité commence par les limites que nous construisons autour de lui : ce qu’il peut lire, ce qu’il peut modifier, les destinations avec lesquelles il peut communiquer et les actions qui nécessitent une approbation humaine. Plus l’IA devient autonome, plus l’architecture qui contrôle cette autonomie devient importante. »
Les agents de codage transforment la manière dont les logiciels sont développés.
Mais le passage de la suggestion de code à l’exécution autonome entraîne également un changement dans la manière dont la sécurité doit être envisagée.
Il ne suffit plus de contrôler uniquement le code produit par l’IA.
Nous devons également contrôler l’environnement dans lequel l’IA opère.
Le système de fichiers, le réseau, les identifiants, la sandbox, les politiques d’accès et l’approbation humaine deviennent des composantes d’une même architecture de sécurité.
Dans ce modèle, un agent de codage ne doit pas être considéré comme un processus auquel on accorde automatiquement sa confiance.
Il doit être considéré comme un composant doté de privilèges limités, d’un comportement observable et d’actions contrôlables.
Car dans le développement logiciel assisté par l’IA, la prochaine question de sécurité ne sera pas seulement :
« Le code est-il sécurisé ? »
Mais aussi :
« L’agent qui l’a construit était-il sécurisé ? »