Votre panier est vide.
Quand le contexte entrave l’IA : pourquoi un agent doit-il aussi savoir quoi oublier ?
02 Oct
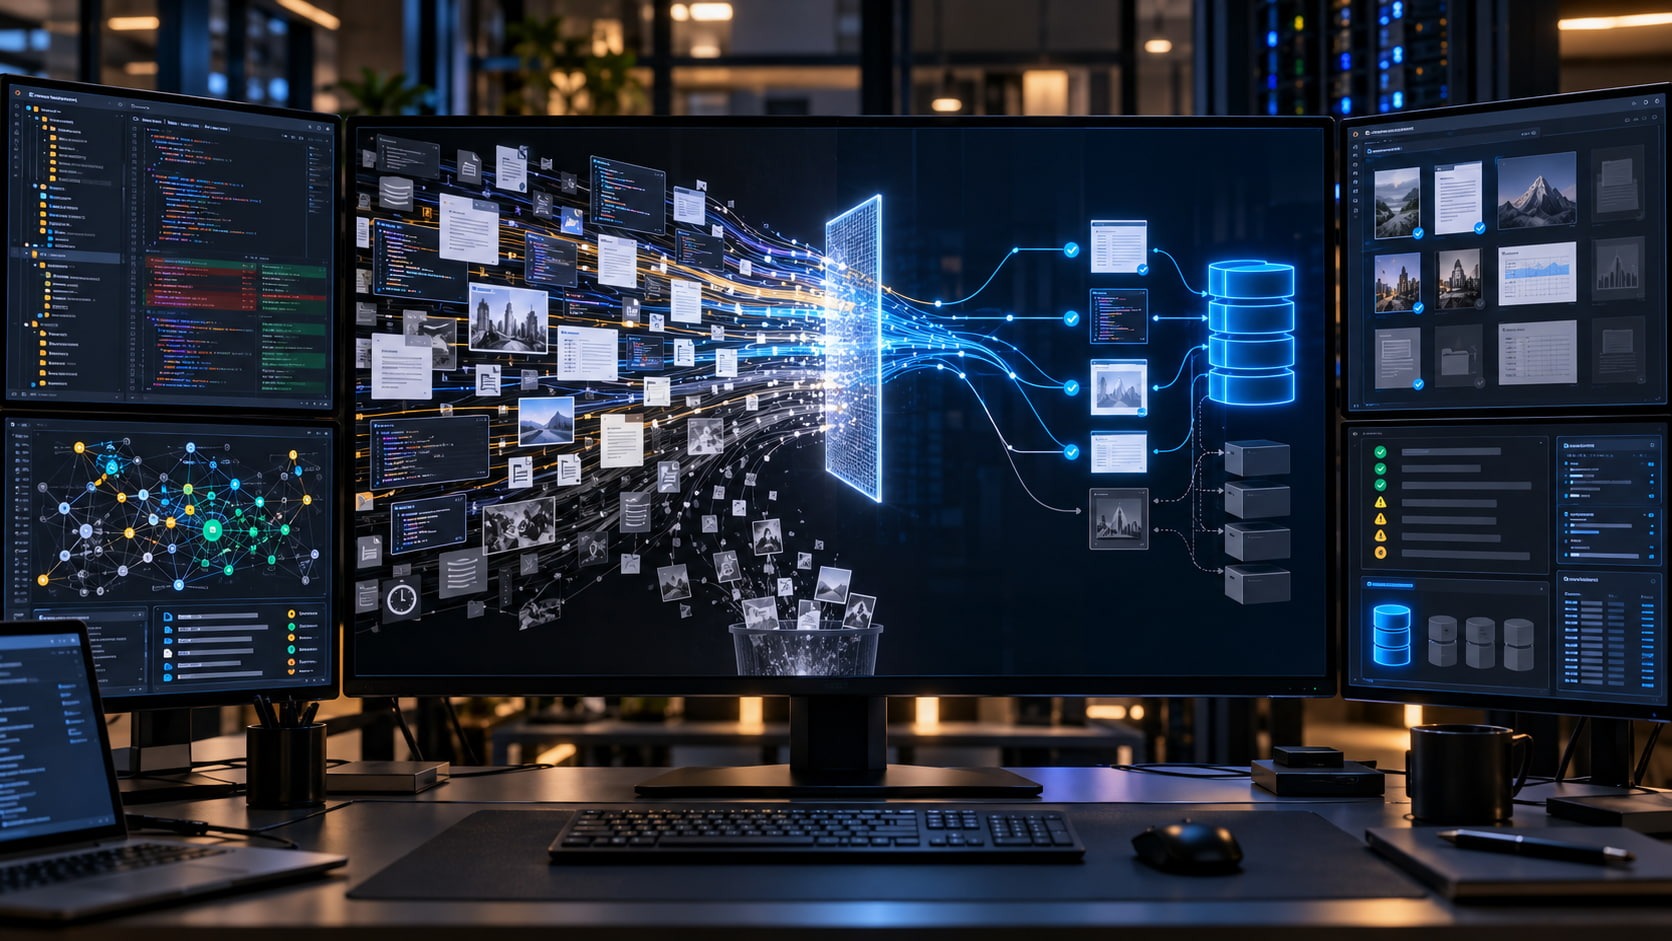
Lorsqu’un agent d’IA travaille sur une tâche de développement logiciel, le contexte constitue l’une de ses ressources les plus importantes. Il peut inclure la demande de l’utilisateur, les fichiers du projet, l’historique des modifications, les instructions de l’équipe, l’architecture du système et les conclusions tirées de tâches précédentes.
À première vue, il peut sembler que plus un agent reçoit d’informations, meilleur sera le résultat. Si l’IA connaît davantage de parties du repository et conserve un historique plus complet, elle devrait être en mesure de prendre des décisions plus précises.
Mais la quantité de contexte n’est pas synonyme de qualité du contexte.
Des informations obsolètes, non pertinentes ou contradictoires peuvent éloigner l’agent du problème qu’il doit résoudre. Au lieu de l’aider, un historique excessif peut rendre le processus plus coûteux, plus lent et moins ciblé.
GitHub a annoncé que ses chercheurs avaient créé un benchmark à partir de séquences réelles de pull requests et analysé l’impact de l’accumulation du contexte. Le sujet, qui sera présenté lors de GitHub Universe 2026, porte précisément sur ce qu’un agent doit mémoriser et sur les informations qu’il doit laisser de côté.
Cela déplace la question de « Quelle quantité de contexte l’IA peut-elle conserver ? » vers une interrogation plus importante : « Quel contexte reste pertinent pour la tâche actuelle ? »
Le contexte et la mémoire ne sont pas la même chose
Le contexte correspond aux informations qu’un agent utilise pendant une tâche spécifique. Il peut inclure le prompt, les fichiers ouverts, les résultats de recherche, les réponses des outils et les réponses précédentes.
La mémoire, quant à elle, correspond aux informations conservées pour être utilisées lors de tâches futures.
Un agent peut découvrir, par exemple, qu’une version d’API doit rester cohérente dans le code client, le serveur et la documentation. Cette conclusion peut également être utile lors d’une modification future.
Si cette information est enregistrée dans la mémoire, un autre agent pourra l’utiliser ultérieurement afin de vérifier si tous les emplacements concernés ont été mis à jour.
Mais toutes les informations rencontrées pendant une tâche ne doivent pas être conservées.
Un fichier ouvert par hasard, une branche de développement qui n’a jamais été fusionnée avec la base de code principale ou une solution temporaire ne doivent pas être automatiquement considérés comme des connaissances durables sur le projet.
La gestion du contexte de l’IA exige donc une distinction claire entre les informations temporaires et les connaissances qui méritent d’être conservées.
Davantage d’informations peuvent détourner l’agent du problème
Lors d’une revue de code, l’agent doit déterminer si la modification proposée crée un véritable problème. Pour cela, il doit généralement commencer par le diff et rechercher uniquement le code lié à la question examinée.
S’il commence plutôt par explorer largement le repository, chaque résultat de recherche et chaque fichier consulté intègrent son contexte de travail.
Ces informations continuent d’accompagner le raisonnement de l’agent, même lorsqu’elles ne sont plus utiles. Par conséquent, l’agent peut consacrer davantage de ressources à l’analyse d’éléments non pertinents et perdre de vue la modification qu’il doit examiner.
GitHub a rapporté un cas dans lequel de meilleurs outils d’exploration du code ont initialement dégradé les performances de Copilot lors des revues de code. L’agent effectuait des recherches trop larges, consultait davantage de code que nécessaire et accumulait du contexte tout au long du processus. Après avoir adapté les instructions afin de l’inciter à commencer par le diff et à rechercher des éléments de preuve limités, le coût moyen des revues a été réduit d’environ 20 %, tout en maintenant le même niveau de qualité.
Cela montre que la capacité à trouver davantage d’informations ne constitue pas toujours une amélioration. La véritable valeur réside dans la capacité à trouver les bonnes informations.
Le contexte doit correspondre à la tâche
Un agent qui implémente une fonction et un agent qui examine une pull request n’ont pas les mêmes besoins en matière de contexte.
L’agent chargé d’implémenter une modification peut avoir besoin de comprendre l’architecture d’un module, ses dépendances avec d’autres composants et la manière dont la fonctionnalité est testée.
L’agent chargé de la revue de code doit être plus ciblé. Il doit commencer par la modification précise, formuler des questions spécifiques et rechercher uniquement les éléments nécessaires pour confirmer ou écarter un problème.
Même lorsque les deux agents utilisent les mêmes outils, leur manière de recueillir le contexte doit être différente.
Cela signifie que la gestion du contexte ne peut pas être résolue par une règle universelle. Chaque rôle doit disposer de limites claires, de stratégies de recherche et de critères définissant les informations qu’il peut charger.
Un agent ne doit pas consulter l’intégralité du repository simplement parce qu’il en a la capacité. Il doit examiner la partie liée à la décision qu’il tente de prendre.
Une information correcte aujourd’hui peut être erronée demain
Le logiciel évolue continuellement.
Une règle identifiée dans une branche du projet peut être remplacée avant même que cette branche ne soit fusionnée. Une convention de programmation peut changer. Un composant peut être supprimé, tandis qu’une dépendance peut être remplacée par une autre solution.
Si l’IA enregistre une conclusion sans vérifier sa source, elle risque de continuer à l’utiliser même lorsque cette information n’est plus valide.
Le problème ne réside pas seulement dans le fait que la mémoire est ancienne. Le problème est qu’elle peut encore paraître convaincante.
Une conclusion enregistrée par l’IA peut être clairement formulée et sembler techniquement correcte, même si le code actuel ne la confirme plus.
Pour cette raison, la mémoire ne doit pas être considérée comme une vérité immuable. Elle doit être traitée comme une information qui nécessite une vérification par rapport à l’état actuel du système.
La mémoire doit également conserver sa source
Une façon de limiter l’utilisation de souvenirs inexacts consiste à associer chaque information enregistrée à la référence qui la justifie.
Dans le système décrit par GitHub, les éléments de mémoire sont enregistrés avec des citations renvoyant à des emplacements précis du code. Avant d’utiliser une information mémorisée, l’agent vérifie en temps réel si les fichiers et les sections référencés la confirment toujours.
Si le code contredit la mémoire ou si l’emplacement n’existe plus, l’agent ne doit pas utiliser l’ancienne conclusion. Il peut la corriger en fonction des nouveaux éléments disponibles.
Cette approche déplace la vérification au moment de l’utilisation. Au lieu d’essayer de nettoyer continuellement l’ensemble de la mémoire, le système vérifie les informations lorsqu’elles deviennent nécessaires pour une tâche spécifique.
GitHub indique que, lors de ses tests, l’utilisation d’une mémoire vérifiée a permis d’augmenter la précision de 3 % et le rappel de 4 % pendant les revues de code.
La mémoire peut donc améliorer le résultat, mais uniquement lorsque les informations sont enregistrées et utilisées avec des mécanismes de vérification.
L’oubli fait partie de l’intelligence du système
L’oubli est généralement considéré comme une limitation. Dans les systèmes d’IA, il peut constituer un mécanisme de contrôle important.
Une information mémorisée qui n’a pas été utilisée pendant une longue période peut ne plus être pertinente. Les informations impossibles à vérifier doivent être supprimées. Une conclusion associée à une branche abandonnée ne doit pas continuer à influencer de nouvelles tâches.
Copilot Memory limite les éléments mémorisés au niveau du repository et les vérifie par rapport à la base de code actuelle avant leur utilisation. GitHub applique également une période d’expiration automatique de 28 jours, tandis que les propriétaires du repository peuvent consulter et supprimer ces éléments.
Cela montre que l’oubli ne doit pas se produire de manière aléatoire. Il peut être conçu au moyen de périodes d’expiration, de la vérification des sources et de contrôles administratifs.
Un bon système de mémoire n’est pas celui qui conserve tout. C’est celui qui conserve les informations utiles aussi longtemps qu’elles restent valides.
Le contexte doit être sélectionné et non chargé intégralement
Lorsqu’il commence une nouvelle tâche, l’agent peut avoir accès à l’historique des conversations, à la documentation, aux informations mémorisées sur le repository, aux fichiers et aux résultats de processus précédents.
Charger toutes ces données dans le prompt ne constitue pas nécessairement la meilleure stratégie.
Le système doit déterminer quelles informations sont liées à l’objectif actuel. Une tâche concernant l’authentification peut nécessiter les règles de sécurité et les dépendances correspondantes, mais pas l’historique d’une ancienne modification de l’interface graphique.
Cela exige des mécanismes permettant de rechercher, classer et filtrer la mémoire. Les informations peuvent être évaluées selon leur pertinence par rapport à la question, leur date de création, la fiabilité de leur source et leur validité dans le code actuel.
L’objectif n’est pas de remplir la fenêtre de contexte. L’objectif est de fournir à l’agent le minimum d’informations dont il a besoin pour prendre une décision précise.
La mémoire partagée peut diffuser aussi bien les connaissances que les erreurs
Lorsque plusieurs agents d’IA travaillent sur le même projet, la mémoire peut permettre aux connaissances découvertes par un agent d’être utilisées par les autres.
Un agent chargé de la revue de code peut identifier une convention importante. Un agent de programmation peut l’appliquer lors de la création d’un nouveau service, tandis qu’un agent utilisant le terminal peut s’en servir pour diagnostiquer un problème.
Cela peut réduire la nécessité d’expliquer le même contexte à chaque agent.
Mais la mémoire partagée crée également un risque. Si une information incorrecte est enregistrée sans être vérifiée, elle peut se propager dans plusieurs processus. Une seule erreur peut affecter l’implémentation, la revue de code et le diagnostic.
Par conséquent, le partage de la mémoire doit s’accompagner d’un partage des preuves. Les agents ne doivent pas uniquement hériter d’une conclusion, mais également de la possibilité d’en vérifier la source.
La gestion du contexte devient une composante de l’architecture
Dans les systèmes traditionnels, le contexte peut simplement faire partie du prompt. Lorsque les agents d’IA commencent à intervenir dans des processus de longue durée, il devient un composant architectural.
Le système doit définir où la mémoire est stockée, qui peut la créer, quels agents peuvent la consulter, combien de temps elle reste active et comment sa validité est vérifiée.
Il doit également être possible de comprendre quelles informations ont influencé la décision d’un agent.
Si l’IA propose une modification fondée sur une information mémorisée précédemment, l’équipe doit pouvoir consulter le contenu de cette mémoire, identifier le code dont elle provient et vérifier si elle a été validée avant son utilisation.
La gestion du contexte devient ainsi une composante de l’audit, de la sécurité et de la responsabilité du système.
L’IA doit savoir non seulement ce qu’elle sait, mais aussi pourquoi elle le sait
Pour ALSoft, la mémoire d’un agent d’IA ne doit pas être considérée comme un réservoir illimité d’informations.
Sa valeur dépend de sa capacité à relier chaque conclusion à une source, à la vérifier par rapport à l’état actuel du système et à la supprimer lorsqu’elle n’est plus valide.
Comme l’explique Ermal Beqiri, fondateur d’ALSoft :
« Un agent d’IA ne devient pas plus précis simplement parce qu’il conserve davantage d’informations. Il doit distinguer ce qui est pertinent pour la tâche actuelle, vérifier si la mémoire reste confirmée par le système et laisser de côté le contexte qui n’est plus valide. L’intelligence ne réside pas uniquement dans ce que l’agent mémorise, mais aussi dans la manière dont il choisit ce qu’il utilise. »
Les agents d’IA évoluent progressivement de conversations isolées vers des processus pouvant se poursuivre à travers plusieurs tâches, outils et étapes de développement. Dans ce modèle, la mémoire peut préserver les connaissances liées au projet et rendre le travail plus cohérent.
Mais une mémoire incontrôlée peut créer du bruit, augmenter les coûts et diffuser des informations obsolètes.
Pour cette raison, la gestion du contexte de l’IA ne doit pas chercher à tout conserver. Elle doit définir ce qui mérite d’être préservé, comment ces informations sont vérifiées et à quel moment elles doivent être oubliées.
L’IA la plus utile n’est pas celle qui se souvient de tout. C’est celle qui utilise la bonne information, au bon moment et pour la bonne raison.