Nessun prodotto nel carrello.
Quando il contesto ostacola l’AI: perché un agente deve sapere anche cosa dimenticare?
02 Oct
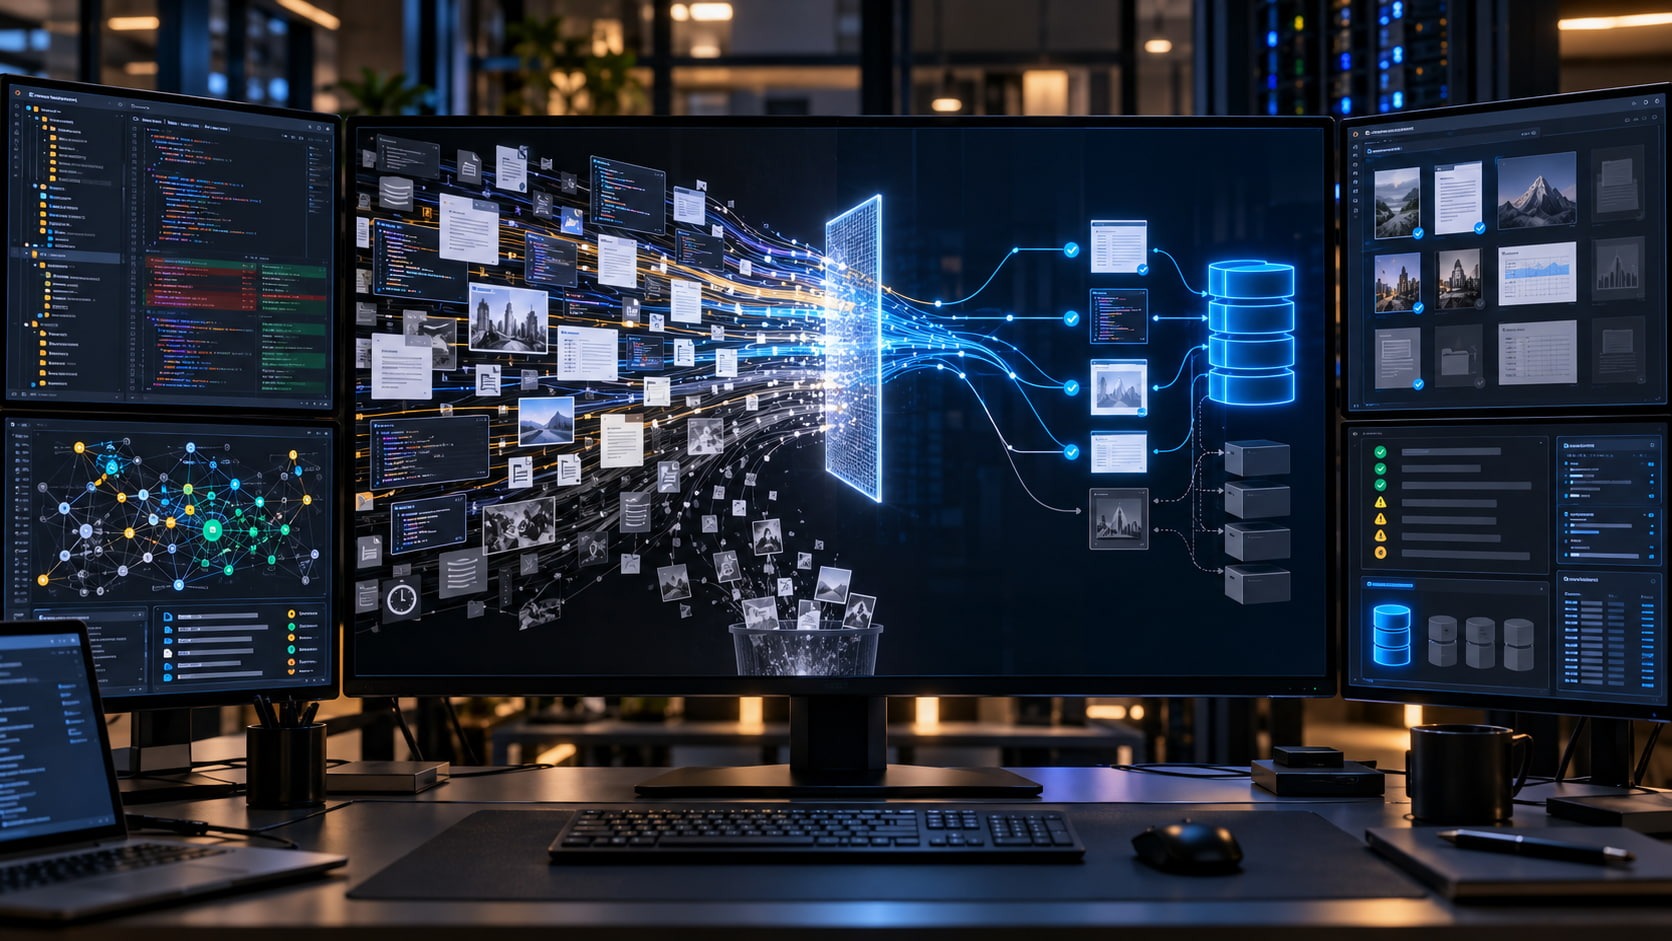
Quando un agente AI lavora a un’attività di sviluppo software, il contesto rappresenta una delle sue risorse più importanti. Può includere la richiesta dell’utente, i file del progetto, la cronologia delle modifiche, le istruzioni del team, l’architettura del sistema e le conclusioni tratte da attività precedenti.
A prima vista, potrebbe sembrare che più informazioni riceve un agente, migliore sarà il risultato. Se l’AI conosce più parti del repository e conserva una cronologia più completa, dovrebbe essere in grado di prendere decisioni più precise.
Ma la quantità di contesto non equivale alla qualità del contesto.
Informazioni obsolete, irrilevanti o contraddittorie possono allontanare l’agente dal problema che deve risolvere. Invece di essere d’aiuto, una cronologia eccessiva può rendere il processo più costoso, più lento e meno mirato.
GitHub ha annunciato che i suoi ricercatori hanno creato un benchmark utilizzando sequenze reali di pull request e hanno analizzato l’impatto dell’accumulo del contesto. Il tema, che sarà presentato durante GitHub Universe 2026, riguarda precisamente ciò che un agente deve ricordare e le informazioni che dovrebbe lasciare da parte.
Questo sposta la domanda da “Quanto contesto può conservare l’AI?” a una questione più importante: “Quale contesto è ancora valido per l’attività attuale?”
Il contesto e la memoria non sono la stessa cosa
Il contesto è costituito dalle informazioni che un agente utilizza durante un’attività specifica. Può includere il prompt, i file aperti, i risultati delle ricerche, le risposte degli strumenti e le risposte precedenti.
La memoria, invece, è costituita dalle informazioni conservate per essere utilizzate nelle attività future.
Un agente può scoprire, per esempio, che una versione dell’API deve rimanere coerente nel codice client, nel server e nella documentazione. Questa conclusione potrebbe essere utile anche durante una modifica futura.
Se questa informazione viene salvata nella memoria, un altro agente potrà utilizzarla successivamente per verificare se tutte le parti interessate sono state aggiornate.
Ma non tutte le informazioni che emergono durante un’attività devono essere conservate.
Un file aperto per caso, un ramo di sviluppo che non è mai stato integrato nella base di codice principale o una soluzione temporanea non dovrebbero essere automaticamente considerati conoscenze durature sul progetto.
La gestione del contesto AI richiede quindi una distinzione chiara tra le informazioni temporanee e le conoscenze che meritano di essere conservate.
Una maggiore quantità di informazioni può distogliere l’agente dal problema
Durante una revisione del codice, l’agente deve determinare se la modifica proposta crea un problema reale. Per farlo, generalmente deve iniziare dal diff e cercare soltanto il codice collegato alla questione esaminata.
Se invece comincia a esplorare ampiamente il repository, ogni risultato della ricerca e ogni file consultato entrano a far parte del suo contesto di lavoro.
Queste informazioni continuano ad accompagnare il ragionamento dell’agente anche quando non sono più utili. Di conseguenza, l’agente può impiegare più risorse nell’analisi di materiale irrilevante e perdere di vista la modifica che deve esaminare.
GitHub ha riportato un caso in cui strumenti migliori per l’esplorazione del codice hanno inizialmente peggiorato le prestazioni di Copilot durante la revisione del codice. L’agente effettuava ricerche troppo ampie, consultava più codice del necessario e accumulava contesto durante tutto il processo. Dopo aver modificato le istruzioni per guidarlo a iniziare dal diff e cercare elementi di prova limitati, il costo medio delle revisioni è stato ridotto di circa il 20%, mantenendo lo stesso livello di qualità.
Ciò dimostra che la capacità di trovare più informazioni non rappresenta sempre un miglioramento. Il valore risiede nella capacità di trovare le informazioni giuste.
Il contesto deve corrispondere all’attività
Un agente che implementa una funzione e un agente che esamina una pull request non hanno le stesse esigenze di contesto.
L’agente che implementa una modifica potrebbe dover comprendere l’architettura di un modulo, le sue dipendenze da altri componenti e il modo in cui la funzionalità viene testata.
L’agente incaricato della revisione del codice deve essere più mirato. Dovrebbe iniziare dalla modifica specifica, formulare domande precise e cercare soltanto gli elementi necessari per confermare o escludere un problema.
Anche quando entrambi gli agenti utilizzano gli stessi strumenti, il modo in cui raccolgono il contesto dovrebbe essere diverso.
Ciò significa che la gestione del contesto non può essere risolta con una regola universale. Ogni ruolo dovrebbe avere limiti chiari, strategie di ricerca e criteri che definiscano le informazioni che può caricare.
Un agente non dovrebbe leggere l’intero repository soltanto perché può farlo. Dovrebbe consultare la parte collegata alla decisione che sta cercando di prendere.
Un’informazione corretta oggi potrebbe essere errata domani
Il software cambia continuamente.
Una regola identificata in un ramo del progetto potrebbe essere sostituita prima che quel ramo venga integrato. Una convenzione di programmazione potrebbe cambiare. Un componente potrebbe essere rimosso, mentre una dipendenza potrebbe essere sostituita da un’altra soluzione.
Se l’AI salva una conclusione senza verificarne la fonte, potrebbe continuare a utilizzarla anche quando l’informazione non è più valida.
Il problema non consiste soltanto nel fatto che la memoria sia vecchia. Il problema è che potrebbe continuare ad apparire convincente.
Una conclusione salvata dall’AI può essere formulata chiaramente e sembrare tecnicamente corretta, anche se il codice attuale non la supporta più.
Per questo motivo, la memoria non dovrebbe essere considerata una verità immutabile. Dovrebbe essere trattata come un’informazione che richiede una verifica rispetto allo stato attuale del sistema.
La memoria deve conservare anche la propria fonte
Un modo per limitare l’utilizzo di ricordi inesatti consiste nell’associare ogni informazione salvata al riferimento che la supporta.
Nel sistema descritto da GitHub, i ricordi vengono salvati con citazioni che rimandano a posizioni specifiche nel codice. Prima di utilizzare un ricordo, l’agente verifica in tempo reale se i file e le sezioni citati continuano a supportare quell’informazione.
Se il codice contraddice il ricordo o se la posizione non esiste più, l’agente non dovrebbe utilizzare la vecchia conclusione. Può correggerla sulla base delle nuove prove disponibili.
Questo approccio sposta la verifica al momento dell’utilizzo. Invece di cercare di ripulire continuamente l’intero archivio della memoria, il sistema verifica le informazioni quando diventano necessarie per un’attività specifica.
GitHub afferma che, durante i suoi test, l’utilizzo di una memoria verificata ha prodotto un aumento del 3% della precisione e del 4% del richiamo durante la revisione del codice.
La memoria può quindi migliorare il risultato, ma soltanto quando le informazioni vengono salvate e utilizzate attraverso meccanismi di verifica.
Dimenticare fa parte dell’intelligenza del sistema
Dimenticare viene generalmente considerato un limite. Nei sistemi di AI, può rappresentare un importante meccanismo di controllo.
Un ricordo che non viene utilizzato da molto tempo potrebbe non essere più pertinente. Le informazioni che non possono essere verificate dovrebbero essere eliminate. Una conclusione associata a un ramo abbandonato non dovrebbe continuare a influenzare le nuove attività.
Copilot Memory limita i ricordi al livello del repository e li verifica rispetto alla base di codice attuale prima del loro utilizzo. GitHub stabilisce inoltre un periodo di scadenza automatica di 28 giorni per i ricordi, mentre i proprietari del repository possono esaminarli ed eliminarli.
Ciò dimostra che l’oblio non dovrebbe avvenire casualmente. Può essere progettato attraverso periodi di scadenza, verifica delle fonti e controlli amministrativi.
Un buon sistema di memoria non è quello che conserva tutto. È quello che conserva le informazioni utili finché rimangono valide.
Il contesto deve essere selezionato, non caricato integralmente
Quando inizia una nuova attività, l’agente può avere accesso alla cronologia delle conversazioni, alla documentazione, ai ricordi relativi al repository, ai file e ai risultati dei processi precedenti.
Caricare tutti questi dati nel prompt non rappresenta necessariamente la strategia migliore.
Il sistema dovrebbe determinare quali informazioni sono collegate all’obiettivo attuale. Un’attività riguardante l’autenticazione potrebbe richiedere le regole di sicurezza e le dipendenze pertinenti, ma non la cronologia di una vecchia modifica dell’interfaccia grafica.
Ciò richiede meccanismi per la ricerca, la classificazione e il filtraggio della memoria. Le informazioni possono essere valutate in base alla loro pertinenza rispetto alla domanda, al momento in cui sono state create, all’affidabilità della fonte e alla loro validità nel codice attuale.
L’obiettivo non è riempire la finestra di contesto. L’obiettivo è fornire all’agente la quantità minima di informazioni necessarie per prendere una decisione precisa.
La memoria condivisa può diffondere sia le conoscenze sia gli errori
Quando diversi agenti AI lavorano allo stesso progetto, la memoria può consentire agli altri agenti di utilizzare le conoscenze acquisite da uno di essi.
Un agente incaricato della revisione del codice potrebbe identificare una convenzione importante. Un agente di programmazione può applicarla durante la creazione di un nuovo servizio, mentre un agente che utilizza il terminale può servirsene per diagnosticare un problema.
Ciò può ridurre la necessità di spiegare lo stesso contesto a ogni agente.
Ma la memoria condivisa crea anche un rischio. Se un’informazione errata viene salvata senza essere verificata, può diffondersi in diversi processi. Un singolo errore può influenzare l’implementazione, la revisione del codice e la diagnostica.
Per questo motivo, la condivisione della memoria dovrebbe essere accompagnata dalla condivisione delle prove. Gli agenti non dovrebbero ereditare soltanto una conclusione, ma anche la possibilità di verificarne la fonte.
La gestione del contesto diventa parte dell’architettura
Nei sistemi tradizionali, il contesto può semplicemente far parte del prompt. Quando gli agenti AI iniziano a operare in processi di lunga durata, diventa un componente architetturale.
Il sistema deve definire dove viene conservata la memoria, chi può crearla, quali agenti possono consultarla, per quanto tempo rimane attiva e come viene verificata la sua validità.
Dovrebbe inoltre essere possibile comprendere quali informazioni abbiano influenzato la decisione di un agente.
Se l’AI propone una modifica basata su un ricordo precedente, il team dovrebbe poter vedere che cosa conteneva quel ricordo, da quale codice è stato ricavato e se è stato verificato prima dell’utilizzo.
In questo modo, la gestione del contesto diventa parte dell’audit, della sicurezza e della responsabilità del sistema.
L’AI deve sapere non soltanto ciò che sa, ma anche perché lo sa
Per ALSoft, la memoria di un agente AI non dovrebbe essere considerata un archivio illimitato di informazioni.
Il suo valore dipende dalla capacità di collegare ogni conclusione a una fonte, verificarla rispetto allo stato attuale del sistema ed eliminarla quando non è più valida.
Come afferma Ermal Beqiri, fondatore di ALSoft:
«Un agente AI non diventa più preciso semplicemente perché conserva più informazioni. Deve distinguere ciò che è rilevante per l’attività attuale, verificare se la memoria continua a essere supportata dal sistema e lasciare da parte il contesto che non è più valido. L’intelligenza non risiede soltanto in ciò che l’agente ricorda, ma anche nel modo in cui sceglie ciò che deve utilizzare.»
Gli agenti AI stanno passando dalle conversazioni isolate a processi che possono proseguire attraverso diverse attività, strumenti e fasi dello sviluppo. In questo modello, la memoria può preservare le conoscenze relative al progetto e rendere il lavoro più coerente.
Ma una memoria incontrollata può creare rumore, aumentare i costi e diffondere informazioni obsolete.
Per questo motivo, la gestione del contesto AI non dovrebbe concentrarsi sulla conservazione di ogni informazione. Dovrebbe definire che cosa merita di essere conservato, come deve essere verificato e quando deve essere dimenticato.
L’AI più utile non è quella che ricorda tutto. È quella che utilizza l’informazione giusta, al momento giusto e per il motivo giusto.